
Flowise
可视化搭建带共享状态和人工审核的 AI 工作流
 Apify
Apify 是一个以 Actor 为运行单元的网页数据采集与自动化平台。你可以在 Store 中选择现成 Actor,填写输入后在云端运行,也可以开发自己的采集程序,再通过 API、调度或其他工具调用。它解决的是“怎样重复获得结构化数据”,而不只是把网页另存为文件。
使用 Apify 时,最容易混淆的是三个对象:Actor 是程序,Run 是程序的一次执行,Dataset 是保存结果的地方。一次 Run 显示成功,并不代表目标网站的每一页、每个字段都已经采集完整。选工具、限制范围和检查输出,都需要围绕具体数据任务进行。
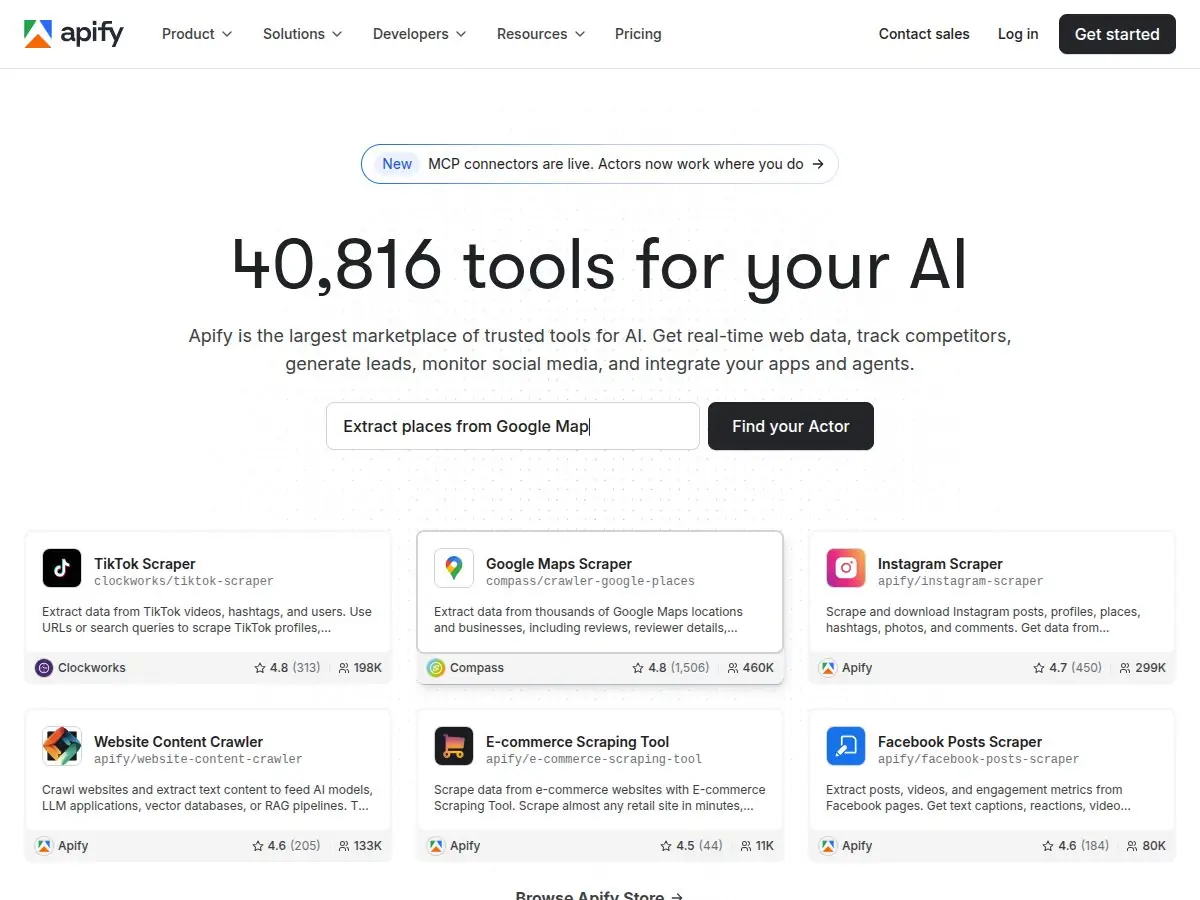
假设你要把自有公开文档整理成可供检索的文本,应优先寻找网页正文提取工具,而不是只因某个 Actor 名称含有“AI”就选择它。Apify 官方的 Website Content Crawler 就面向网页内容提取,可输出文本、Markdown 等数据,并提供抓取范围和浏览器模式设置。
| 选型时查看什么 | 为什么影响结果 |
|---|---|
| 维护者、说明和近期运行信息 | 不同 Actor 由不同开发者维护,支持范围与更新节奏并不相同 |
| 输入示例与必填项 | 有的接收页面 URL,有的接收搜索词、列表或更复杂参数 |
| 输出字段与样例 | 要确认提供正文、来源 URL 还是仅标题摘要,不能靠名称猜测 |
| 价格模式 | 按用量、结果、事件或租用收费,会形成不同的成本结构 |
同样叫“网页采集”的工具,可能一个只处理给定页面,另一个会继续发现链接。开始运行之前,把“需要哪些字段、覆盖哪些路径、最多处理多少页”写清楚,通常比运行后再清洗成千上万条无关记录更有效。
下面以自有公开文档站为例说明配置思路,没有实际执行抓取。进入 Actor 的 Input 页面,把文档入口填入 Start URLs,先将 Max pages 限制为少量页面,例如 10 页,并按站点结构设置深度或排除路径。这个数量是初次检查用的示例,不是平台推荐的统一额度。
Start URLs 决定从哪里开始,后续链接发现则受路径与排除规则等条件影响。该 Actor 的排除 URL 规则针对发现的链接,不应被理解为一定会过滤你明确填写的起始 URL。若不希望采集某个入口,最直接的做法是不要把它放进起始列表。
文档站常有多语言目录、版本目录、标签页和打印版。它们可能看起来属于同一个站,却不都适合进入你的知识库。先排除明显无关的路径,再检查少量结果中的 URL,能及时发现抓取范围是否偏离了“当前版本的正文”。
当前输入说明提供自适应、无头 Firefox 和原始 HTTP 等模式。原始 HTTP 不执行页面 JavaScript,适合正文直接存在于 HTML 中的页面;需要脚本加载正文或交互后显示内容时,浏览器模式才可能取得相应结果。自适应模式会在受支持的方式之间处理选择,但仍应检查实际输出。
不要默认“开浏览器一定更准确”。它增加了页面加载和等待环节,有时抓到的只是弹窗、空状态或未完成加载的区域。等待、滚动等配置要与页面行为对应;用于浏览器渲染的设置,也不能期待在纯 HTTP 请求中产生同样作用。
从运行日志可以观察处理过程,再到输出和存储区域检查记录。至少抽查一个入口页、一个较深层页面和一个较长页面,分别查看:
页面上限、已加载页面数和最终保存记录数不一定相等。例如,规范地址去重可能让已加载的重复页面计入处理数量,却不形成新的保存记录。此时不能简单认定 Actor 少抓了几条,也不能只看到条数接近上限就认为内容齐全。应把预期页面清单与实际 URL 对照,判断缺口来自范围、去重还是提取失败。
Dataset 用来保存按条组织的结果。你可以在界面查看表格或 JSON,并导出 CSV、JSON、Excel、JSONL 等格式。给表格分析使用时,优先核对列名和嵌套字段;给程序或知识库处理时,JSON/JSONL 通常更容易保留结构。换一种导出格式不会自动补齐 Actor 没有采到的字段。
Dataset 采用追加式存储,不适合当作随时修改单行的业务数据库。发现错误后,常见做法是调整输入并重新运行、在下游清洗或另建结果集,而不是直接把原 Dataset 当电子表格逐格修正。多次采集同一网站,还需要自行约定时间戳、来源地址和去重键。
留存也要主动规划。官方存储文档区分命名与未命名 Dataset:命名的数据集可长期保留,未命名数据集默认有 7 天留存限制,具体仍以适用设置为准。重要结果不宜只留在一次临时运行里,应及时命名、导出或同步到自己的存储。
API 启动 Actor 后,得到运行信息不等于已拿到最终数据。程序要等待运行达到相应状态,再读取对应 Dataset。官方客户端的调用方法可以等待运行,并通过返回的默认 Dataset 标识读取条目;如果使用原始 API,就要自行处理等待、分页和失败情况。
定时任务适合周期性更新;Webhook 适合在运行达到指定状态后通知其他系统。连接自动化平台时,也应确认下一步接收的是 Run 信息还是数据条目。否则一个流程虽然每晚都触发,表格里写入的却可能只是任务编号。
Apify 还提供 MCP 接入,让支持该协议的 AI 客户端调用相关工具。这不会取消账号、权限和费用要求,也不意味着 Store 中每个 Actor 都是独立运行的 MCP 服务。AI 选择了工具以后,输出字段与来源的检查责任仍然存在。
开发者可以使用 Crawlee 等抓取框架构建程序,再交由 Apify 的 Actor 运行环境执行,利用日志、存储、调度及代理等能力。适合把需要重复运行的采集逻辑产品化,而不只是上传一段只在本机成功过的脚本。对外提供 Actor 时,还要维护输入说明、输出契约和目标网站变化后的兼容性,不能把上架理解成稳定收益保证。
费用要按所选 Actor 拆开看。有的按平台资源用量计费,有的按结果或事件收费,也有租用模式。Website Content Crawler 的代码可用,不代表运行时计算、代理或其他平台资源完全不产生成本。先用小样本观察耗时、结果条数与费用,再估算定时运行的月度消耗。
代理和浏览器渲染可以解决部分访问与加载问题,但不构成采集授权。对自有或获准处理的数据,Apify 可以把一次性脚本变成可重复的数据流程;涉及受限内容、个人资料或再分发时,则应先确认权限与用途,不能用“技术上抓得到”代替判断。