B.AI
面向智能体的去中心化推理基建,支持链上微支付。
 DeepInfra
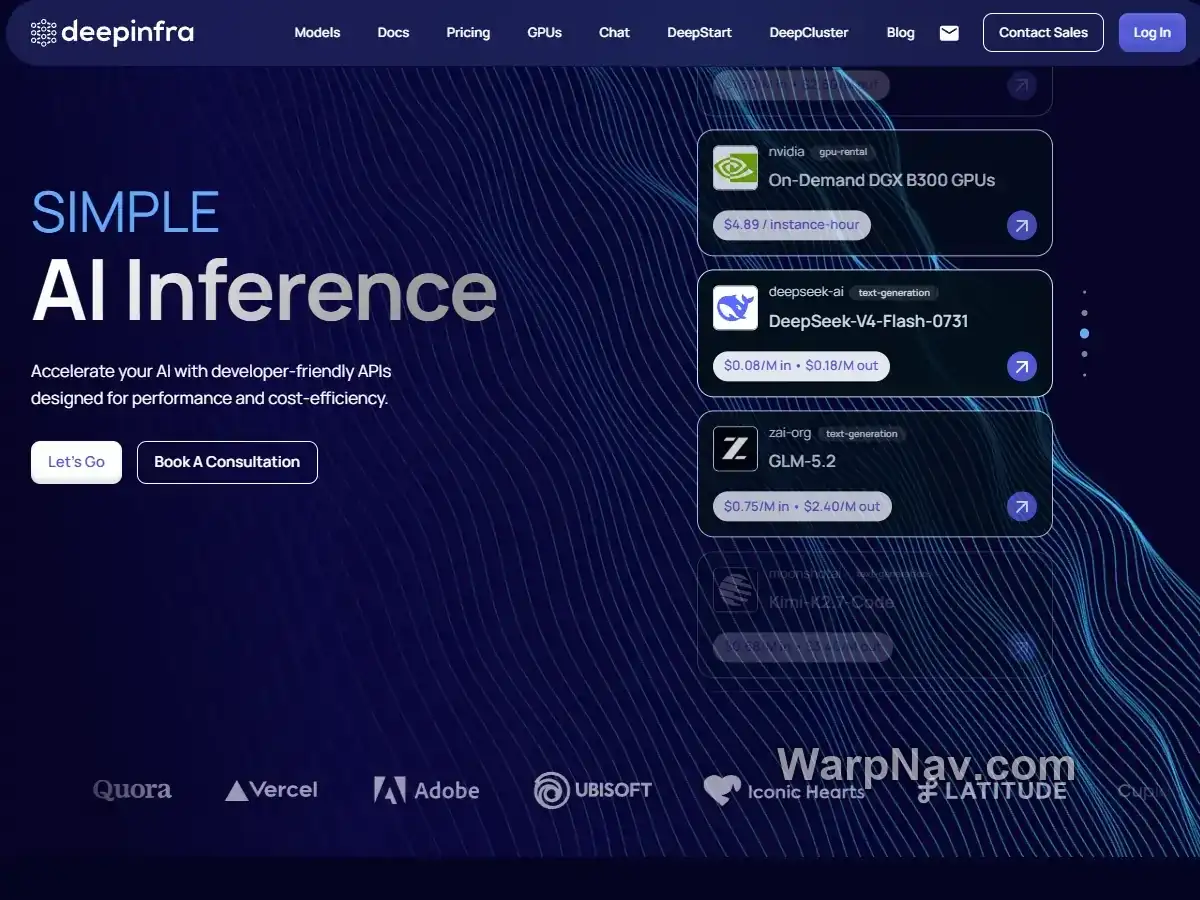
 是面向开放模型的推理云,提供 OpenAI 兼容接口、原生多模态 API、模型目录、私有模型部署和 GPU 资源。它适合希望沿用现有 OpenAI 客户端、又需要访问多种开放权重模型的开发者;如果要部署自己的权重或处理非聊天任务,则要进一步理解原生端点和专用部署。模型、价格、硬件与参数会变化,使用前应以当前模型页和文档为准。
| 入口 | 适合的任务 | 关键差异 |
|---|---|---|
| OpenAI-compatible | 聊天、文本补全、Embedding、部分图像生成,以及已有 OpenAI SDK 的应用。 | 把 base URL 指向 https://api.deepinfra.com/v1/openai,再替换 token 与 model;具体能力仍由模型页决定。 |
| DeepInfra Native API | 图像生成、语音识别、目标检测、分类、Rerank 或需要 webhook、log probabilities 等原生能力的任务。 | 使用 https://api.deepinfra.com/v1/inference/{model_name},请求字段和返回结构按模型类型变化。 |
双入口的价值在于迁移成本和覆盖范围可以分开处理:先用兼容接口验证聊天应用,再在确实需要原生能力时切换,而不是为了“统一”把所有模型都强行套进 Chat Completions。迁移评测要保留模型字符串、请求字段、流式设置和错误码,避免只比较最终文本。
DEEPINFRA_TOKEN;不要把真实 token 写进浏览器代码、仓库、截图或日志。DeepInfra 原生接口同样要求 Bearer 认证,但不同任务的输入可能是 JSON、表单或文件上传。不要仅凭模型名称猜字段;先打开对应模型页的 API 区块,确认输入模态、必填参数和输出下载方式。
DeepInfra 目录覆盖聊天与文本、视觉与 OCR、Embedding、Rerank、图像/视频生成以及语音等任务。筛选时建立一张小型决策表,而不是只按排行榜选模型:
目录会不断加入或移除模型。任何“最便宜”“最新”或“最快”的结论都应带上查询日期、地区、硬件和负载条件,不要把首页当前展示的价格卡片当成长期基线。
当前文档除兼容与原生推理外,还单列 Batch API、GPU Instances、Sandboxes 和 Hosted Agents。它们解决的问题不同:批处理适合不要求即时返回的成组任务,Sandbox/Hosted Agents 面向受控执行或代理运行,GPU 与私有模型承担更强的资源和隔离需求。先确认任务是否需要状态管理、文件、执行环境或专用算力,再决定入口,不要把所有新能力都包装成一条聊天请求。
当需求超出文本对话时,DeepInfra Native API 会直接暴露模型类型:图像生成通常返回可下载的图片结果,语音识别接收音频文件,目标检测和图像分类接收图片,Embedding 则返回向量。请求流程应围绕输入文件、异步状态和输出保存设计,而不是只替换一个模型名。
| 方式 | 优势 | 成本/风险 |
|---|---|---|
| 共享模型 API | 按请求或 token 使用,启动快,适合原型和波动流量。 | 模型版本、共享资源和限流受平台影响;不适合需要自有权重或强隔离的场景。 |
| 私有 LLM / LoRA 部署 | 自己的权重、独立端点、可预测延迟和自动扩缩,可用 OpenAI 兼容接口访问。 | 按 GPU-hour 计费,空闲实例仍可能产生费用;要管理 GPU、实例数、模型大小和启动时间。 |
| GPU 集群 | 适合训练、实验或希望拥有 SSH 与基础设施控制的团队。 | 运维、网络、存储、监控和安全责任显著增加,不应按简单 API 项目估算。 |
DeepInfra 文档支持从 Hugging Face 等来源部署自有模型和 LoRA 适配器。上线前先确认权重格式、GPU 显存、最大 batch、min/max instances、scale-to-zero 和区域;部署后设置消费上限,避免忘记关闭低流量实例。共享 per-token 与私有 per-GPU-hour 的盈亏平衡点应通过真实并发和利用率计算,而不是比较单个标价。
除了完整 API key,DeepInfra 还提供可限制模型、有效期和支出上限的 scoped JWT,适合把推理能力交给前端、客户或第三方而不暴露主密钥。令牌应按项目和环境分开,定期轮换,并在服务端检查超时、限流和回退。
最终的生产清单应包括:固定模型与版本、兼容/原生端点、token 权限、超时与重试、成本告警、模型回退、离线评测和数据删除验证。这样 DeepInfra 的模型广度才会转化为可控的工程选择,而不是不可追踪的供应商切换。
官网:https://deepinfra.com/