
OpenNana
从提示词案例进入站内图片或视频生成
 LiblibAI(哩布哩布)
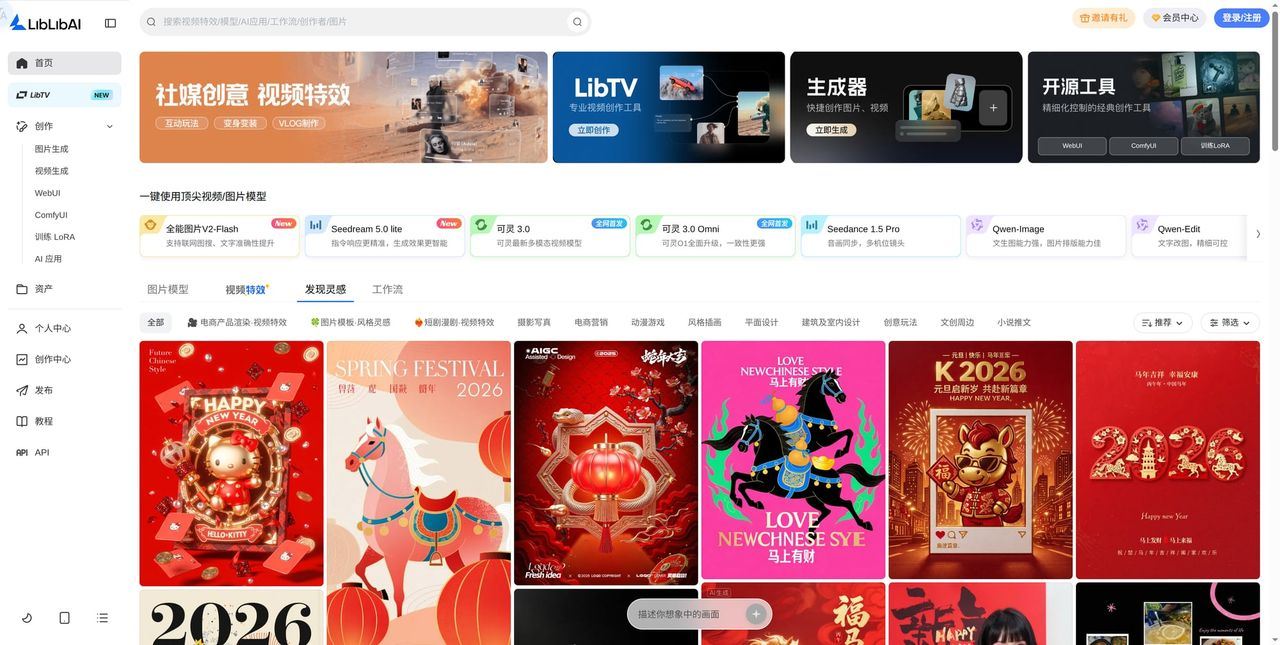
是聚焦本土化开源生态的高人气 AI 模型社区与在线算力平台。在开源生成式扩散模型的实际落地过程中,设计团队往往受制于本地显卡显存瓶颈、Python 环境依赖冲突以及海外模型权重下载延迟等工程阻碍。LiblibAI 通过将海量开源底模、细分领域 LoRA 权重与云端无代码化 ComfyUI 节点链路深度打通,构建了一套免除本地硬件消耗的标准化生产管道。深入理解其底模架构兼容逻辑、元数据触发词规范以及云端节点编排机制,是工程团队低成本释放多模态视觉资产效能的核心前提。
平台的核心竞争力不仅在于海量模型索引,更在于针对本土创意场景提供了多层级的基底适配方案。开源社区经历了从 SD1.5、SDXL 到 FLUX 架构的技术迭代,不同底模在文本语义编码器与参数规模上存在本质差异。早期 SD1.5 凭借极其庞大的垂直微调生态,在人像精修与电商挂拍微调中依然具备极高灵活性;而新一代 FLUX 架构通过引入流匹配(Flow Matching)与增强的 T5 文本理解能力,在多实体空间关系解析与文字排版渲染上展现出显著优势。创作者在挑选模型时,必须严格比对基底版本,杜绝跨架构挂载导致的特征崩溃与画面结构畸变。
对于显存受限或重视生成效率的商业团队,平台在线算力还支持多种精度的量化权重调度。从原生 FP16 到高效 FP8 及 GGUF 格式,创作者无需在本地繁琐配置编译环境即可一键调用。理解不同量化级别在细微发丝与微观纹理表现上的取舍,有助于在批量渲染与单张精修之间寻得最佳算力平衡。
在实际生产调用中,LoRA 模型的激活极度依赖精确的提示词语法与权重系数。部分微调模型若缺少特定的前置触发词(Trigger Word),往往无法引导潜在空间走向目标特征分布。在构建自动化调度流水线时,需将模型元数据中的触发词与权重映射写入标准配置规范:
{
  "base_model": "FLUX.1-dev",
  "lora_stack": [
    {
      "model_name": "guochao_hanfu_v2.safetensors",
      "weight": 0.85,
      "trigger_words": ["guochao_style", "traditional_hanfu", "silk_texture"]
    }
  ],
  "sampler_settings": {
    "sampler_name": "euler",
    "scheduler": "simple",
    "steps": 28,
    "cfg_scale": 3.5
  }
}
配置时应将关键触发词置于正向提示词前 75 个 Token 内,避免注意力权重随序列推移发生衰减。若同时挂载多个功能性微调层,必须通过逐级调节权重来避免潜在特征冲突。规范的参数结构不仅便于团队内部知识沉淀,也为后续对接自动化渲染脚本提供了稳定的数据契约。
平台提供的在线 ComfyUI 画布为模块化视觉生产提供了坚实底座。创作者无需配置本地复杂运行环境,直接在浏览器端串联采样器、VAE 解码、IP-Adapter 姿态引导与多重面部修复节点,实现高度可复现的生成管线。
当电商或影视项目需要同时融入服装 LoRA、特定光影 LoRA 与面部特征 LoRA 时,权重线性叠加极易导致画面过曝或结构形变。合理的工程做法是将总权重绝对值控制在 1.2 以内,优先保证主体轮廓 LoRA 占主导权重,光影与材质微调层则降至 0.3 至 0.5。若画面出现严重色彩斑块,应检查 CLIP 跳过层数(CLIP Skip)是否与模型作者的训练设置严格一致,并适度调低引导比例以恢复动态平衡。
在企业级批量交付场景中,需清晰核算云端算力点数与生成时长的转化关系。批量并发任务宜采用低步数蒸馏模型进行打样粗选,锁定满意种子后再切入高步数节点进行精修渲染。此外,使用社区资产必须核查创作者声明的商用许可协议(如 CC-BY-NC 或专属商用授权条款),严格区分个人学习用途与商业交付范围,确保最终导出的数字物料具备无争议的版权合规性。