DeepSeek
开源 MoE 大模型先锋、深度强化学习推理与技术部署指南。
 智谱AI
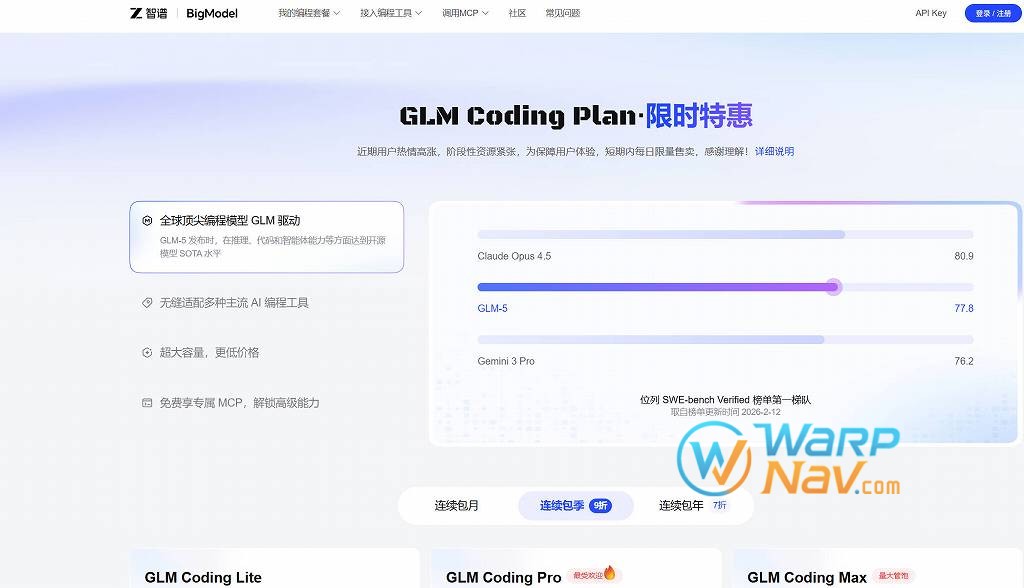
智谱AI(Zhipu AI)源自清华大学计算机系知识工程实验室的技术积淀,是中国人工智能基础大模型领域极具自主创新实力与全栈研发能力的领军科技企业。依托自研的双向自回归通用语言模型(GLM)架构体系,智谱AI 打破了西方主流以 GPT 因果语言模型为主导的技术路径,在中文语义理解、复杂长文本推理、多模态图文解析以及前沿视频生成领域取得了举世瞩目的突破。通过 BigModel 开放平台,智谱AI 为开发者与企业提供高性能模型推理 API 与知识库微调基础设施。深入掌握其工程接入最佳实践,是构建本土合规智能应用的关键路径。
智谱AI 之所以能在激烈的大模型竞赛中确立技术壁垒,核心在于其对底层算法架构的自主创新坚持:
“在大模型百舸争流的时代,真正的底层突破不能依赖对国外开源架构的简单微调或换皮照搬。自研 GLM 架构将自编码模型的双向上下文捕捉能力与自回归模型的生成灵活性有机融合,从数学机理上为中国自主可控的通用人工智能构筑了稳固的学术基石与工程底座。”
在产品矩阵演进上,平台实现了全模态能力的系统性贯通。旗舰级大模型 GLM-4 在逻辑推理、代码编写、复杂指令遵循以及智能体工具调用(Function Calling)方面达到了工业级交付标准。结合 CogView 与 CogVideoX 视频扩散模型,智谱构筑了从文字、图像到动态视频的端到端技术生态链。
在工程接入 BigModel 开放平台时,技术人员应针对具体业务形态进行精细化架构适配:
对于面向终身用户的对话式交互界面或高交互智能体场景,必须优先采用流式输出(stream=True)模式。通过基于 HTTP SSE 协议的持续数据推送,前端应用能够以极低的首字等待延迟(TTFT)逐步渲染模型回答,大幅改善用户的等待焦虑感。同时在后端逻辑中,应配合智能分块缓存与取消令牌机制,以便在用户提前关闭会话时及时向服务端发送中断请求,杜绝不必要的算力空耗。
视频生成与高分辨率图像解析属于极度消耗 GPU 算力的复杂长任务,API 通常采用异步任务提交与轮询查询(Polling)机制。工程架构师应设计可靠的异步消息队列(如 Redis/RabbitMQ)来解耦前端请求与模型任务调度,配置基于指数退避(Exponential Backoff)的查询重试逻辑,并在任务完成后通过 Webhook 异步回调将渲染成果安全回写至对象存储系统中。
将大模型 API 从测试 Demo 推向成千上万用户访问的生产环境,必须落实严密的安全与稳定性审查:
通过这套严谨的工程风控清单,企业能够在尽享前沿大模型强大推理红利的同时,将生产事故与合规风险控制在最低限度。
尽管 GLM-4 具备支持百万级 Token 超长上下文的强大解析能力,但在面对海量企业级私有知识时,盲目将整本手册或全部代码仓填入上下文窗口不仅会导致推理成本激增,更会引发大模型固有的“迷失在中间(Lost in the Middle)”幻觉失真现象。
工业级方案是将长文本能力与专业 RAG 工作流紧密结合。先通过向量嵌入模型与重排算法筛选最相关的片段,再由大模型归纳与校对。坚持以真实文档为锚点确保输出可查验溯源,方能在商业场景中站稳脚跟。