
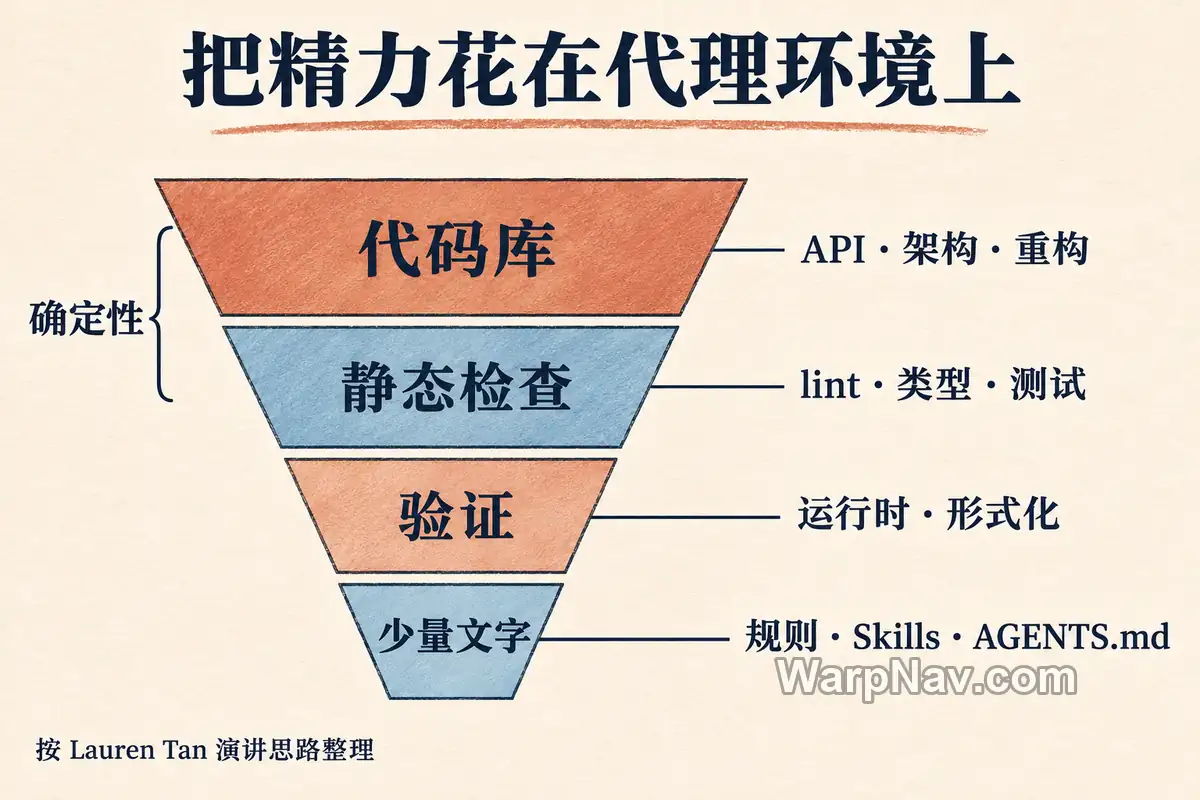
AI 写代码犯了错,最顺手的做法是在 AGENTS.md 或 CLAUDE.md 里再加一句“不要这样做”,但仅靠文字提醒,未必能稳定拦住同一种错误。Lauren Tan 在 11 月 11 日 AI Engineer CODE 2026 主舞台的演讲《All Code Is Slop (Except Mine)》把这件事讲得很直白:代理是照着输入写代码的,而代码库本身就是它最重要的输入之一。她的建议是,能固化的纠正尽量落到 API 和架构、lint 和类型、测试及运行验证里,把需要判断的内容留给简短文字。她把这个顺序画成一个“倒金字塔”。这篇把她的方法拆开,配一张“这次纠正该落到哪一层”的决策表,个人开发者和小团队从下一次纠正就能用上。
规则越写越长,为何还犯错
一个容易被忽视的原因,是代码库本身也在教代理怎么写。Tan 的说法是:代理根据输入生成输出,代码库是最大的输入之一。仓库里留着的变通写法、反模式、已废弃的接口,在下一个代理眼里就是“这个项目的惯例”,会被照着复制。她用花园打比方:以前代码一次来几个 PR,审查者能盯住每一处新长出来的东西;现在一个工程师背后可能是成百上千个代理,代码像连续不断的水流涌进来,杂草一旦长出来,很快就会蔓延到各处。
她用“以前审三个 PR,现在更像 300 个”的对比形容审查压力。这是演讲中的经验描述,不是对所有团队的统计;要减少反复审同一类问题,可执行约束比单纯加长说明更有帮助。
更麻烦的是,文字有时反而会帮倒忙。Tan 观察到两种情况:一是代理会在文档、代码注释、规则文件里写下“为什么这里可以不按规矩来”的理由,给自己留后门;二是你随口纠正的一个小问题,会被代理当成永远不能违反的铁律,用到不该用的地方。
倒金字塔四层分别管什么
演讲里的金字塔是倒着放的,越靠上越宽、越值得投入时间:
| 层级 | 包含什么 | 性质 | 解决的问题 |
|---|---|---|---|
| 1. 代码库本身 | 好的 API 设计、架构、重构 | 确定性 | 让支持的写法更清楚,减少误用入口 |
| 2. 静态检查 | lint 规则、类型系统、编译器、各类测试 | 确定性 | 自动拦截规则覆盖的错误,减少重复人工检查 |
| 3. 验证 | 运行时验证、形式化验证 | 证据 | 检查行为与性质是否符合目标,为判断提供证据 |
| 4. 少量文字 | 规则、Skills、AGENTS.md | 需要判断 | 保留设计意图、业务取舍与需要上下文的判断 |
Tan 把前两层称为“确定性”,强调的是用可复现约束替代反复提醒。这是她对工程投入的划分,不是说各类测试都属于静态分析,也不是说通过检查就证明代码完全正确。固定环境、输入和规则有助于稳定结果;依赖外部服务、时间或随机性的测试,仍需要控制条件。
演讲里能直接借鉴的三个例子
禁用 useEffect:把一类错误整个消灭
Tan 的团队为 Grok Bot 桌面客户端做了一个叫 Dune 的客户端框架,她形容它像“给 Electron 应用用的 Next.js”,技术上并不新奇,关键在于里面写满了约束和 lint 规则。其中一条经验是:需要很多微妙判断才能用好的东西,往往会产出烂代码。React 的 useEffect 就是典型,人都常用错,代理更用不好。他们的做法是在产品代码里直接禁用它,只允许在 Dune 内部的少数 API 里使用。她称这让团队无需在每次审查中重复抓这类误用。这是 Dune 的局部架构选择:React 官方仍把 Effect 用于与外部系统同步。普通项目应先准备能承接需求的封装,再决定限制什么,不能只把 Hook 禁掉却不给可行路径。
用目录结构传递上下文
在同样是 Electron 应用的 Cursor 里,她见过代理经常把主进程的代码引进渲染进程,造成长任务和界面卡顿。到了 Grok Bot 和 Dune,他们把这件事做成了硬约定:顶层就是两个目录,名字直接叫 electron-renderer 和 electron-main,两边互相引用会被依赖图分析器和 lint 规则拦下。规则本身很好写,换来的是代码审查时少想一件事。
禁掉大部分注释,让报错信息指向根因
还是在 Cursor,代理特别爱用 setTimeout、requestAnimationFrame、requestIdleCallback 这类定时器当“快速修复”,实际上是在给 VS Code 的命令式风格和 React 的声明式风格之间的架构冲突打补丁;大量定时器频繁创建销毁,又引发垃圾回收和卡顿。更糟的是,代理还写了不少注释解释“为什么这里这样修是合理的”,结果定时器越铺越多。吸取教训后,Grok Bot 团队禁掉了 99% 的注释,理由是注释容易过时、人其实不读,而且无法强制执行,还给代理留了不做正确事的借口。她更愿意用带清楚错误信息的 lint 规则,把代理引向根因。这不等于所有项目都该删除 99% 的注释;有用的接口说明与设计理由仍可保留,不能让“解释了这个补丁”替代“检查和修复这个问题”。
这次纠正该落到哪一层
下面这张表是按演讲思路整理的编辑建议,工具都是常见的现成方案,不是演讲原文:
| 你刚纠正 AI 的错误 | 建议落点 | 可用工具示例 |
|---|---|---|
用了项目里不该直接用的 API(如裸用 useEffect、绕过统一的请求封装) |
第 1 层 + 第 2 层:只暴露安全的封装,再用 lint 拦截直接调用 | ESLint no-restricted-imports、no-restricted-syntax |
| 跨层引用(前端引了服务端模块、渲染进程引了主进程) | 第 1 层:用目录表达边界;第 2 层:依赖规则拦截 | eslint-plugin-import 的 no-restricted-paths、dependency-cruiser |
| 空值没处理、参数类型乱传 | 第 2 层:收紧类型 | TypeScript strict、noUncheckedIndexedAccess |
| 改了 A 把 B 弄坏了 | 第 2 层:补一个能复现的测试 | 单元测试、集成测试、属性测试 |
| 界面看起来不对、流程走不通 | 第 3 层:让代理自己把应用跑起来验证 | 浏览器自动化、Chrome DevTools 协议、截图和录屏 |
| 用临时补丁绕过问题(加延时、吞异常) | 第 2 层:禁用该写法,报错信息写明该去修什么 | 自定义 lint 规则及其报错信息 |
| 业务取舍、设计意图、需要人决定的边界 | 第 4 层:写进 AGENTS.md 或 Skill;能自动化的命名格式另交给 lint | 简短、具体、带例子的文字说明 |
先问这个错误能否在合理成本下被程序稳定识别。能,就增加可执行检查;依赖业务上下文或存在较多合理例外,就保留判断说明。检查入口和使用边界仍可在 AGENTS.md 里简要写清。
小团队从哪一步开始
不需要先搭一整套“软件工厂”。Tan 给的起点就是下一次纠正:先写一条 lint 规则,防止新的反模式出现,再回头把旧代码里已有的同类写法清掉。后一步不能省,因为旧写法留在仓库里,代理还会继续照抄。
以前端项目为例,先为确实需要的副作用准备框架接口,再限制产品代码直接导入 useEffect。下面是 JavaScript/JSX 的最小 ESLint 配置:项目安装 ESLint 后,在根目录保存为 eslint.config.mjs;已有配置的项目应合并规则,不覆盖原来的解析与检查设置。
npm install --save-dev eslintexport default [
{
files: ["src/**/*.{js,jsx}"],
ignores: ["src/framework/**"],
languageOptions: {
parserOptions: { ecmaFeatures: { jsx: true } }
},
rules: {
"no-restricted-imports": ["error", {
paths: [{
name: "react",
importNames: ["useEffect"],
message: "产品代码不要直接导入 useEffect,请使用 src/framework 中已实现的封装。"
}]
}]
}
}
];
在 src/check-effect.js 写入 import { useEffect } from "react";,运行 npx eslint src/check-effect.js,应得到禁止导入及自定义提示;相同语句放在 src/framework/ 下,不受这条规则约束。上例只覆盖 JS/JSX,TypeScript/TSX 项目应在现有 TypeScript 解析配置上添加规则,不能只改文件后缀就当作配置完整。
message 出现在检查命中的那一刻,可以直接提示代理使用哪条已存在的路径。这条规则能拦具名导入和命名空间导入,但不能单独封住默认导入后的 React.useEffect、动态导入或所有别名写法;要实现团队级禁用,还需结合所用导入方式补充检查。这里演示的是一个具体落点,而非一条配置覆盖全部误用。
验证这一层也不必一步到位。按她的介绍,团队用 TLA+ 对主要用户流程做模型检查,用 Lean 检查自研虚拟化库的特定算法与性质,也在尝试 Bombadil 的界面属性测试。她称这些做法已帮助发现 bug,但仍在实验,形式化验证也不是银弹;这不能改写成已证明整个应用永远不会闪烁或出错。小项目先做到“代理改完能自己把应用跑起来、截图给你看”,可以为 diff 审查补充可观察的行为证据。
如果你在找现成的“把规范交给机器检查”的例子,站内介绍过两个开源项目:Chrome 团队的 Modern Web Guidance 把前端最佳实践做成代理能查的技能和扫描器,阿里的 Open Code Review 则让固定程序决定审哪些文件、套哪些规则,模型只负责判断。
AGENTS.md 还要不要写
要写,但把文字用在它擅长的地方。倒金字塔没有取消文字层:业务取舍、设计理由、哪些操作需要人决定,往往仍要说明;格式化与一部分命名约定则可以交给程序。AGENTS.md 也适合记录检查命令和工作流入口,让代理知道该如何验证。
这和站内之前解读的 OpenAI 官方 AGENTS.md 与 Skills 优化指南并不矛盾。那篇讲的是文字说明怎么写才不误导、不浪费,这篇讲的是哪些要求更适合由程序来执行。两者可以一起使用:每加一条要求,先考虑能否让 lint、类型或测试执行;能,就以检查作为约束,文字说明入口和必要例外;不能,再把判断标准与具体场景写清。
用 Cursor、Claude Code 或 Codex 的人,可以翻一下自己的规则文件:凡是“不要用 X”“必须通过 Y 调用”“A 目录不能引用 B 目录”这类句子,可以先评估哪些能由 lint、类型或依赖检查稳定覆盖,而不是把整份规则文件机械删掉。
她给的成绩该怎么看
演讲后半段给了一组数字:她本人上个月往生产环境合入了约 3,000 个 PR;团队上个月合入约 11,000 个 PR,客户端约每天发一个稳定版;10 月有约 227 人至少提交过一个 PR;被回滚的 PR 比例稳定在约 0.5%;应用启动、输入、打开和切换对话的速度都比上线时更快。她还引用开发者 Cindy 的说法:每天约 70% 的 token 用于验证;她自己也表示多数 token 用在验证上。这不是给其他团队规定的投入比例。
这些数字在这里按演讲自述记录,本站没有独立核实,也不是方法效果的对照实验。场景是特定 Electron 桌面应用,演讲结尾还推荐了团队产品,因此不能拿来承诺其他项目的产量或缺陷率。真正可迁移的是方法本身:纠正一次,固化一次;让下一次同类错误更容易被系统拦住。可以从自己项目里一条反复出现、确实能稳定识别的问题开始。
资料来源
- AI Engineer CODE 2026 官方演讲页「All Code Is Slop (Except Mine)」(2026-11-11 主舞台,2026-11-16 查阅):https://ai.engineer/code/2026/talks/lauren-tan
- 官方演讲文字稿(机器转写,含直播时间标记):https://ai.engineer/api/code/reading-download/transcripts/lauren-tan.md
- 官方文字稿对应的主舞台直播(本场从 01:01:02 开始):https://www.youtube.com/watch?v=ZZ19zhYnDKY&t=3662s
- React 官方文档:You Might Not Need an Effect:https://react.dev/learn/you-might-not-need-an-effect
- ESLint Flat Config 文档:https://eslint.org/docs/latest/use/configure/configuration-files
- ESLint 文档 no-restricted-imports:https://eslint.org/docs/latest/rules/no-restricted-imports
© 版权声明
本站部分内容源于网络收集,文章等版权归原作者所有,若需删稿请联系管理员邮箱:satomini@warpnav.com
相关文章


暂无评论...
