Typeless 下载与语音输入指南 | AI 听写及多平台设置 - 官网未公开统一版本号
Typeless 是跨平台 AI 语音输入工具,可把口述整理为适合邮件、文档和聊天的文字。
Umi-OCR 是一款免费、开源的离线 OCR 软件,适合在 Windows 或 Linux 电脑上处理截图、剪贴板图片、批量图片和扫描文档。它不仅能把一次截图变成可复制文字,还能批量导出 TXT、Markdown、JSONL 或 CSV,并把扫描 PDF 处理为带文字层的可搜索 PDF。
Umi-OCR 2.1.5 的 Windows 发布包按 OCR 引擎区分,界面与主体功能基本一致;官方说明中 Rapid 版兼容性更稳妥,Paddle 版在部分较老 CPU 上可能遇到初始化错误。Windows 包解压即可运行,Linux 版首次启动需按 Release 说明执行启动脚本。不要把 GitHub 的压缩包资产直链保存为长期入口,应先进入 Releases 页面核对版本、平台、引擎与校验信息。
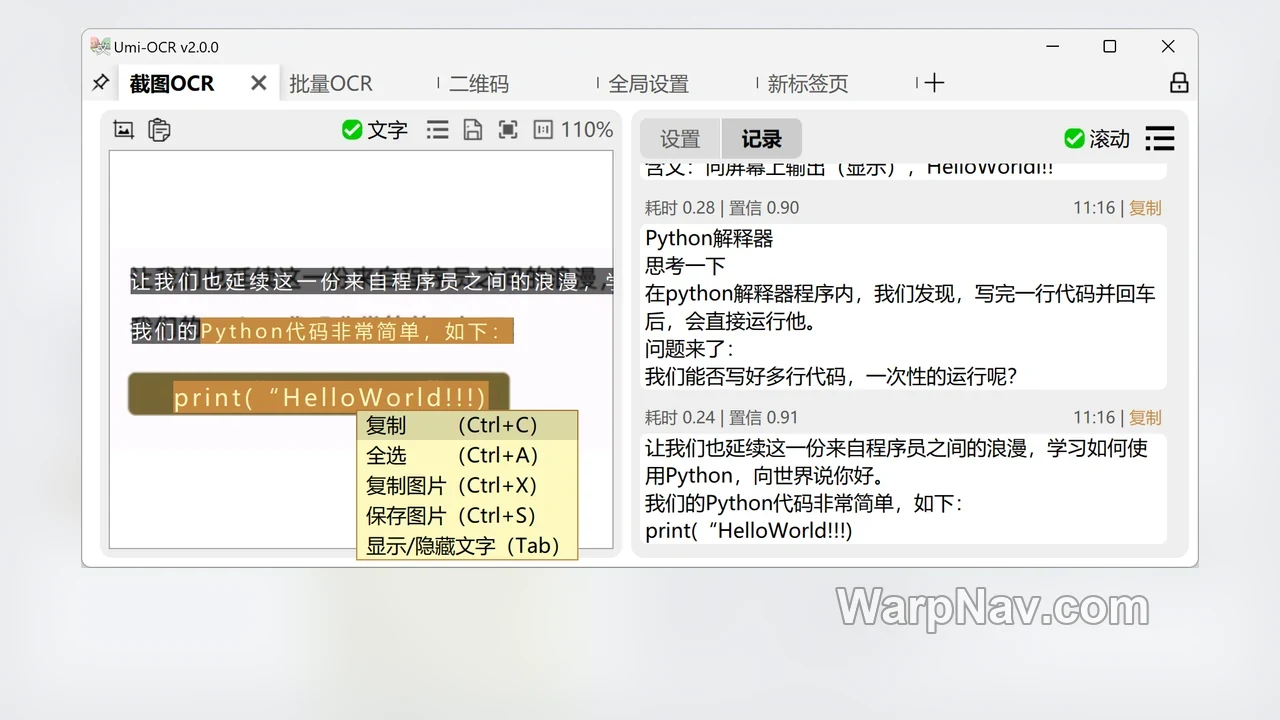
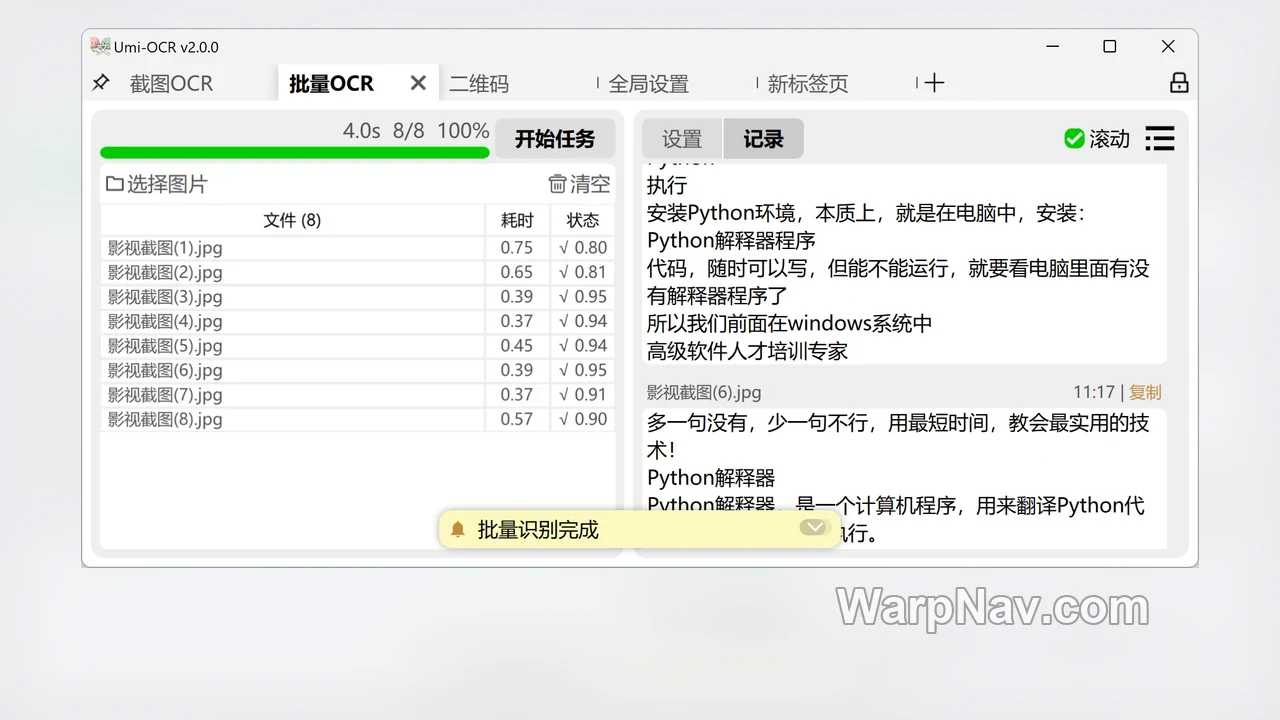
Umi-OCR v2 以标签页组织任务。截图 OCR、批量 OCR、文档识别、二维码和全局设置彼此分开,选择页面实际上就是先确定输入规模和输出形式:临时复制用截图页,多文件导出用批量页,需要保留 PDF 页面外观则使用文档识别。
截图 OCR 页可以通过快捷键框选屏幕区域,也可以把其他软件中复制的图片粘贴进来。左侧保留图片预览,可用鼠标选择识别出的文字;右侧保存识别记录并允许继续编辑或复制。对于网页、视频字幕、不能直接选择的界面文字,这种流程比先保存图片再导入更短。
识别出字符不等于顺序正确。Umi-OCR 提供多栏、单栏、保留缩进和不处理等方案,用来整理换行与文本块顺序。代码截图可以尝试“单栏-保留缩进”,普通文章可比较自然段方案;竖排文字是否可用还取决于所选 OCR 引擎本身。
批量 OCR 页支持导入 JPG、PNG、WebP、BMP、TIFF 等常见图片格式。官方说明可以一次加入大量图片,并把结果保存为 TXT、JSONL、Markdown 或 CSV。这里的 CSV 主要是结构化记录载体,不应理解为能自动还原任意复杂表格。
批量任务中的“忽略区域”适合处理位置固定的页眉、页脚、水印或角标。先在样本上画出需要排除的区域,再检查是否误伤正文;只有完整落在忽略框内的文本块才会被排除,不能把它当成逐字符清理工具。
文档识别支持 PDF、XPS、EPUB、MOBI、FB2 和 CBZ。它可以对扫描页执行 OCR,也可以提取文档已有文本,并输出双层可搜索 PDF。双层 PDF 的页面视觉通常仍由原图承担,文字层用于搜索和复制;这与重排成可编辑 Word 是不同任务。
处理重要文档时应保留原件,用副本试跑少量页面,再检查跨页搜索、数字、标点和阅读顺序。低清图片、手写体、公式、复杂表格和多栏版式仍可能产生错误,软件显示任务完成不代表内容已经无需校对。
Umi-OCR 的 Windows 发布包提供不同 OCR 引擎版本,功能界面基本一致。官方说明把 Rapid 版定位为兼容性较好的选择,Paddle 版对部分较老 CPU 可能出现初始化错误;如果启动识别时报 0xc0000142 或 OCR init fail,Release 说明建议改用 Rapid 版本。
不要仅根据包名推断哪一个对所有图片都更准或更快。更稳妥的方式是准备同一张包含中文、英文、数字和小字号的样图,分别检查错字、段落顺序、耗时和资源占用,再决定长期使用哪一个版本。
官方项目将 Umi-OCR 定位为离线 OCR,识别引擎和多语言库随发布包或插件在本机运行。Windows 版可以解压后启动,不要求传统安装;需要升级时,应先备份旧版本的设置目录,再按官方迁移说明复制配置。
“识别在本机”描述的是 OCR 数据路径,并不代替软件来源检查。下载应进入官方 GitHub Releases、SourceForge 或项目列出的渠道,核对版本与发布者;组织内的合同、证件和客户资料还要服从内部存储、终端和软件使用规范。
扫描 PDF 是否需要 OCR、应该输出可搜索 PDF 还是可编辑文本,可先按 扫描 PDF OCR 处理与验收流程判断。若正在比较系统截图、批量图片、PDF 和长期全文搜索四类任务,可查看 Windows 本地 OCR 工具选择指南;Umi-OCR 的优势主要在离线截图、批量导出和文档识别。
截至 2026-07-29,官方可核验的稳定版为 v2.1.5,Release 日期为 2025-03-25,项目许可证为 MIT。版本、引擎包和平台支持可能继续变化,下载前应以官方 Release 页面为准。