Gemini 4 Argon 已公布,复杂任务评测和长输出能力有进步,但截至 2026 年 10 月 1 日仍未向普通用户全面开放。它在部分任务中领先,也有综合指数和电脑操作上的短板;购买 Google AI Ultra 暂不等于立即获得访问权限。是否值得换用,应同时看任务质量、开放条件和实际成本。Google 公告日期是 9 月 30 日,按发布时间换算,北京时间已进入 10 月 1 日。下面说的“Gemini 4”,主要指这次公布的 Argon 模型。
复杂任务成绩
这次 Argon 重点面向软件工程、企业知识工作和网络安全防御。对日常用 AI 办公的人来说,比较容易理解的,是 Zapier 的 AutomationBench 测试。
它把 AI 放进模拟企业,要求它跨工具完成任务。比如确认一笔业务、查找最新数据、核对规则,再通知正确的人。AI 说了“已完成”还不算,最后要检查事情有没有真的做对。
当前榜单前列如下:
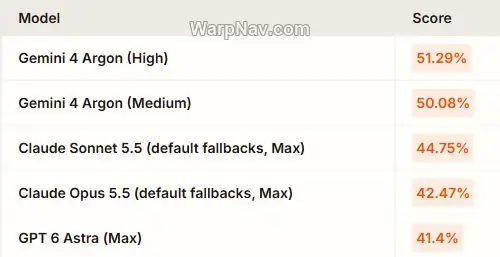
Argon 高推理版本为 51.29%,Claude Opus 5.5(Max,默认回退)为 42.47%,GPT-6 Astra(Max)为 41.4%。
Argon 位居第一。这支持了“复杂工作执行能力有进步”的判断,但榜首仍然只有约一半任务严格通过。想让 AI 接到一句要求后独立做完,仍然要考虑它会在哪些步骤出错。
另外两项受关注的成绩,也可以放在一起看:
- 软件工程:77.9%。 Google 公布的 DeepSWE v1.1 成绩,关注需要持续推进的工程任务。
- 长视频理解:91.7%。 Google 公布的 LVBench 成绩,关注对长视频内容的理解。
来源需要分清:上面的业务自动化成绩能在 Zapier 榜单直接核对;DeepSWE 的 Argon 分数和 LVBench 分数,按 Google 的方法说明,是 Google 自行计算的结果。
Google 公布的对照结果中,Argon 在 DeepSWE v1.1 和 LVBench 领先,但 Terminal-bench 4.0 与 OSWorld-2.0 的部分成绩仍落后于其他模型。不能只摘出领先项,把整张评测表理解成综合排名。
这些成绩说明 Argon 在复杂任务中已有竞争力。“王者归来”能否成立,还需要更多任务和开放后的体验来验证。
百万输出有何用
先想象一个资料整理场景:你有几份方案、几张预算表,希望 AI 核对差异、找出遗漏,再写一份比较报告。这是个假设场景,不是本文的实测。
这件事至少要连续完成几个环节:
- 读资料,弄清各份方案和预算表的内容。
- 交叉核对,找出差异、遗漏和需要进一步确认的地方。
- 整理报告,再检查结论是否和资料一致。
我们希望 AI 少漏条件、少中途停下,也希望它前面发现的问题,到了写报告时还记得处理。
输出上限与上下文
Argon 的输出上限从此前的 64K 提高到 1M,也就是 100 万 token。复杂任务需要持续分析、尝试、检查和修改,更大的推理与生成空间,可能让这些过程走得更远。
这里有两个概念要分开:
- 上下文容量:和模型能处理多少资料、对话内容有关。
- 输出上限:和模型能生成多少内容有关。Token 是计量单位,不能简单等同于一个汉字或一个单词。
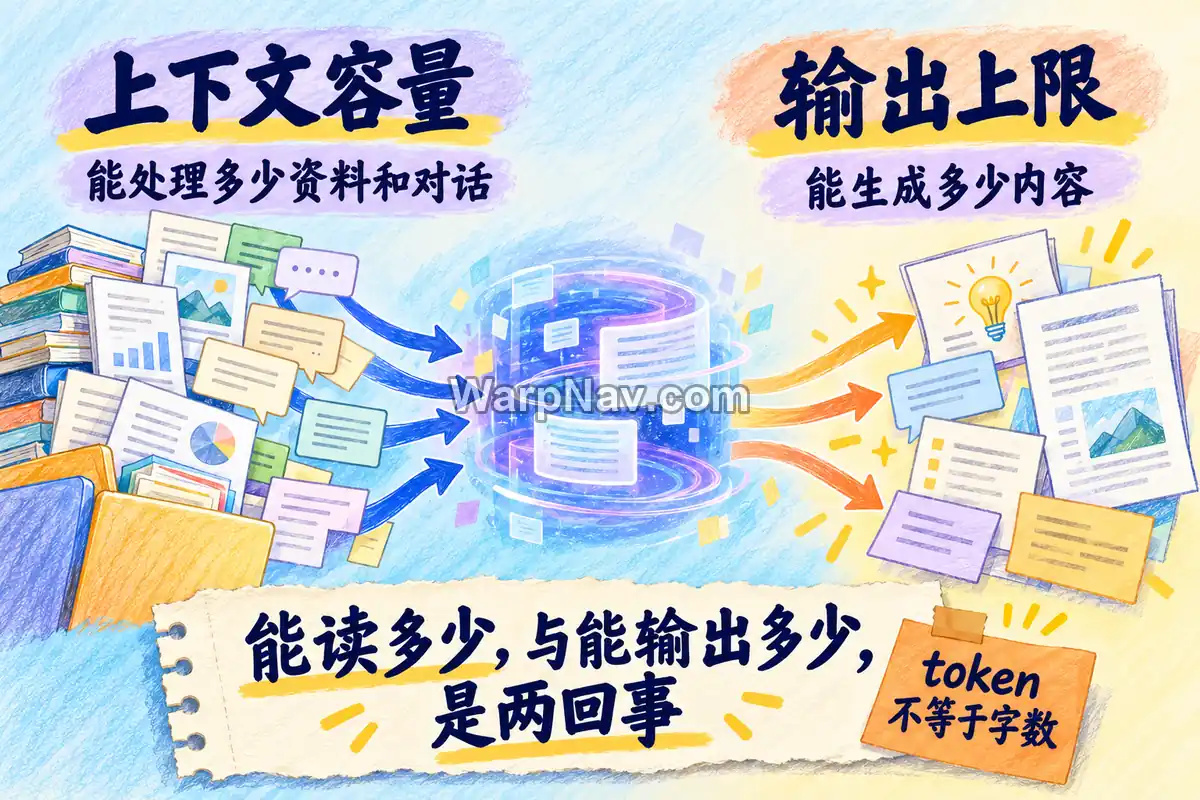
Artificial Analysis 还提到,他们测试了配套的续接机制:长响应可以暂停,再通过后续调用继续。因此,100 万输出不宜想象成普通聊天窗口瞬间吐出百万字,也不是每次任务都能用满。
上限提高,并不保证准确率提高。对读者更有价值的结果,仍然是同一份报告少遗漏、少返工。
另外,Argon 的升级也不能直接等同于 Gemini 里的图片、视频、语音功能全部同步升级,那些能力还要看各自的模型和产品公告。
幻觉率与准确率
很多人对 AI 的不满,是它明明不知道,还能编得特别像真的。找资料时,最麻烦的往往就是这种需要逐条查证的回答。
Artificial Analysis 的独立评测给出了两组值得一起看的数字:
幻觉率:15%。 在 AA-Omniscience 测试中,评测方认为 Argon 更愿意承认知识边界。
准确率:50%。 同一测试中,GPT-6 Astra 的准确率为 63%。
这并不矛盾。一个模型可以更少乱猜,同时也少答出一些正确答案。“少编造”和“知道得更多”,需要分别看。
15% 是特定测试里的幻觉率,不能换算成“日常回答有 85% 的正确率”。
如果你经常用 AI 搜集和整理资料,愿意说“不知道”的模型,可能更容易配合核查。但文章里的日期、引用和产品限制,仍然需要回到原始来源确认。
领先之外的短板
在 Artificial Analysis 的综合智能指数中,Argon 高推理版本得了 53 分,与 GPT-6 Astra 最高推理版本持平;对比页面里的 Claude Opus 5.5 为 58 分。
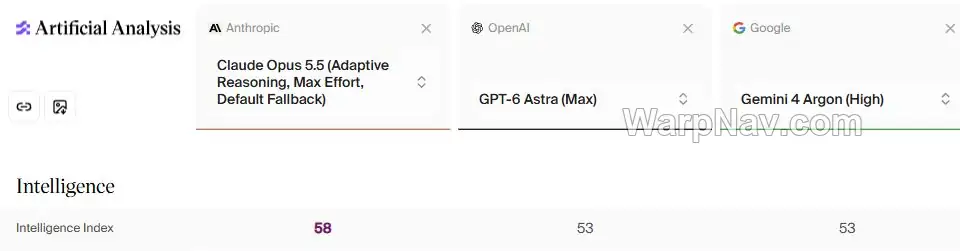
它回到了有竞争力的位置,但还不能据此称为综合第一。
Google 自己的对比表里,也能看到 Argon 没有领先的项目:
- 终端任务测试 Terminal-bench 4.0:Argon 57.4%,Claude Opus 5.5 为 66.4%。
- 电脑操作测试 OSWorld-2.0:在离线子集的部分得分中,Argon 69.2%,GPT-6 Astra 为 72.6%。
这些是不同任务、不同设置下的成绩。Google 的方法说明也指出,对手的部分分数来自厂商自报或公开榜单,并不是全部在完全相同的环境里重跑。
等到开放之后,普通用户还有自己的问题要验证:它处理中文资料、表格、截图时,能不能稳定少犯错?会不会仍然需要反复补充要求?这些体验,单靠榜单还回答不了。
开放时间与价格
Argon 目前通过 Google 的 Fairwind 项目,先向部分可信的网络安全防御团队开放。官方计划后续从付费 API 客户和 Google AI Ultra 订阅者开始扩大访问。
“后续从 Ultra 开始”不代表今天购买 Ultra,就一定能立即选到 Argon。 普通用户的明确开放日期,以及 Pro、免费用户什么时候能用,目前都不能替官方提前下结论。使用额度、地区条件也要看后续说明和账号实际显示。
六成成本的条件
这句话来自 Artificial Analysis 的评测任务成本计算,使用的是首发优惠价。它不能套用到所有任务,也不是聊天会员价格对比。
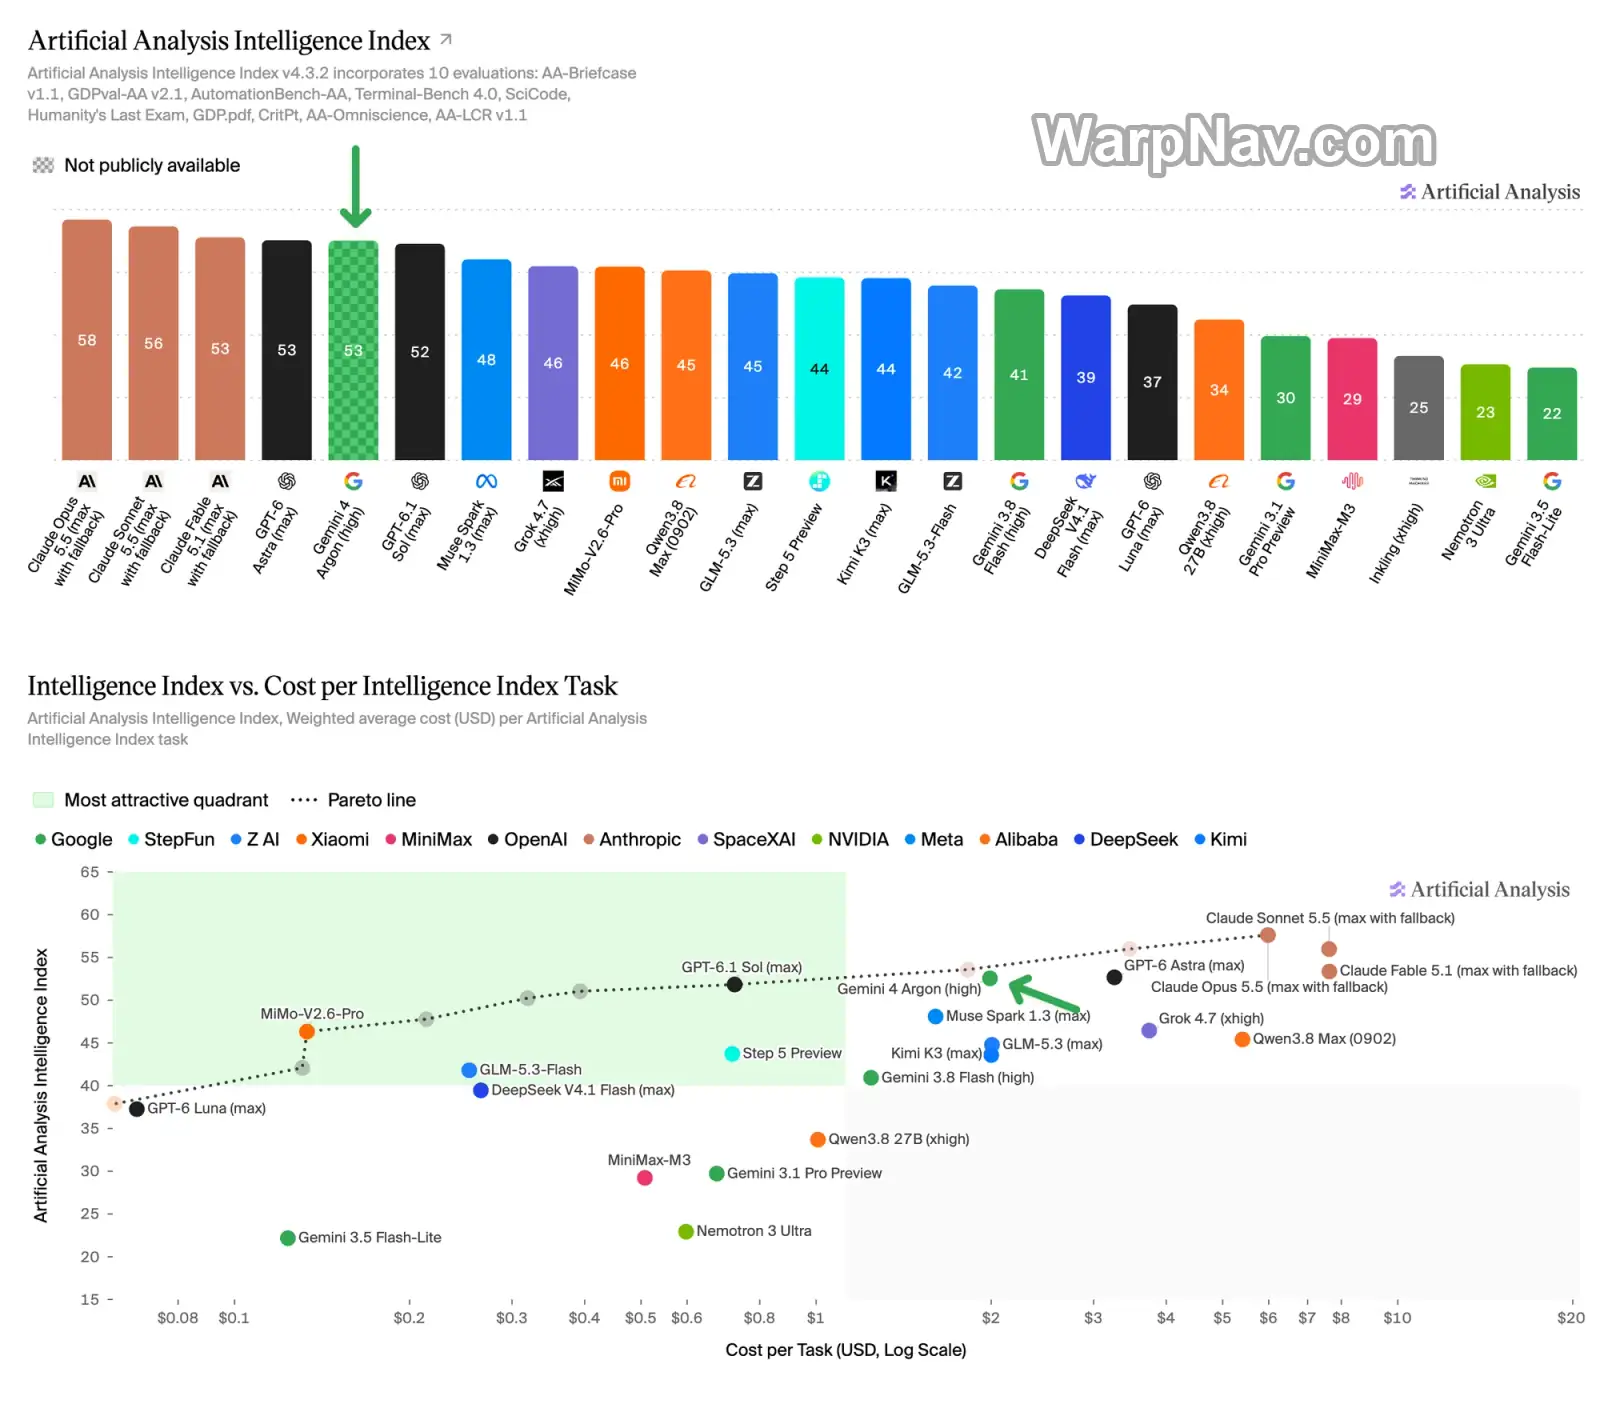
图中的 Argon 每项评测任务成本约为 1.99 美元,Astra 约为 3.26 美元。Artificial Analysis 说明,Argon 恢复标准价后,这项成本会提高到约 3.98 美元。因此,“六成成本”需要和首发折扣一起看。
Google 公布的 API 价格为:
- 首发优惠期:每百万输入 token 2 美元,每百万输出 token 10 美元。
- 优惠结束后:分别提高到 4 美元和 20 美元。
API 按调用用量计费,和普通用户购买会员是两回事。我的建议是,先等自己的账号获得明确访问权限,再考虑为它付费。
开放后怎样比较
让现有 AI 和 Argon 整理同一批信息,重点看:
- 有没有漏掉重要条件,或把不同资料里的内容混在一起。
- 出处能不能核对,不确定的地方有没有说清楚。
- 最后交付的结果,需要你返工多少。
在获得权限前,继续用现有工具即可。获得权限后,用熟悉的任务比较遗漏、出处和返工量,比单看榜单名次更能判断是否值得换用。
入口与资料
WarpNav 的 Gemini 条目可用于查找产品入口;条目存在不代表当前账号能选到 Argon。概念容易混淆时,可参照上下文窗口和长期记忆的区别。
原始资料(核对日期:2026 年 10 月 1 日):
- Google 公告:https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/
- Google 模型成绩:https://deepmind.google/models/gemini/
- Google 评测方法:https://deepmind.google/models/evals-methodology/gemini-4-argon
- Zapier AutomationBench:https://zapier.com/benchmarks
- Artificial Analysis 原始评测:https://artificialanalysis.ai/articles/gemini-4-argon-google-top-three-labs
© 版权声明
本站部分内容源于网络收集,文章等版权归原作者所有,若需删稿请联系管理员邮箱:satomini@warpnav.com
相关文章


暂无评论...
