AI 聊久了“忘记”前文,常见原因是:早先的信息没有进入这次回答可用的材料,或者虽然进来了,却没有被正确利用。上下文窗口限制了模型一次能处理多少内容,但遗忘不一定意味着窗口已经装满。聊天记录保存在界面里、产品保存了你的偏好、模型这次实际参考了什么,是三件不同的事。
记录还在,它怎么没看见?
假设你让 AI 写一份社区活动通知,先交代“周日下午、社区活动室、最多 20 人”。接着讨论了标题、报名方式和几种文案,最后它却写成了“周六上午在公园集合”。你往上一翻,原话明明还在。难道它连翻聊天记录都不会?
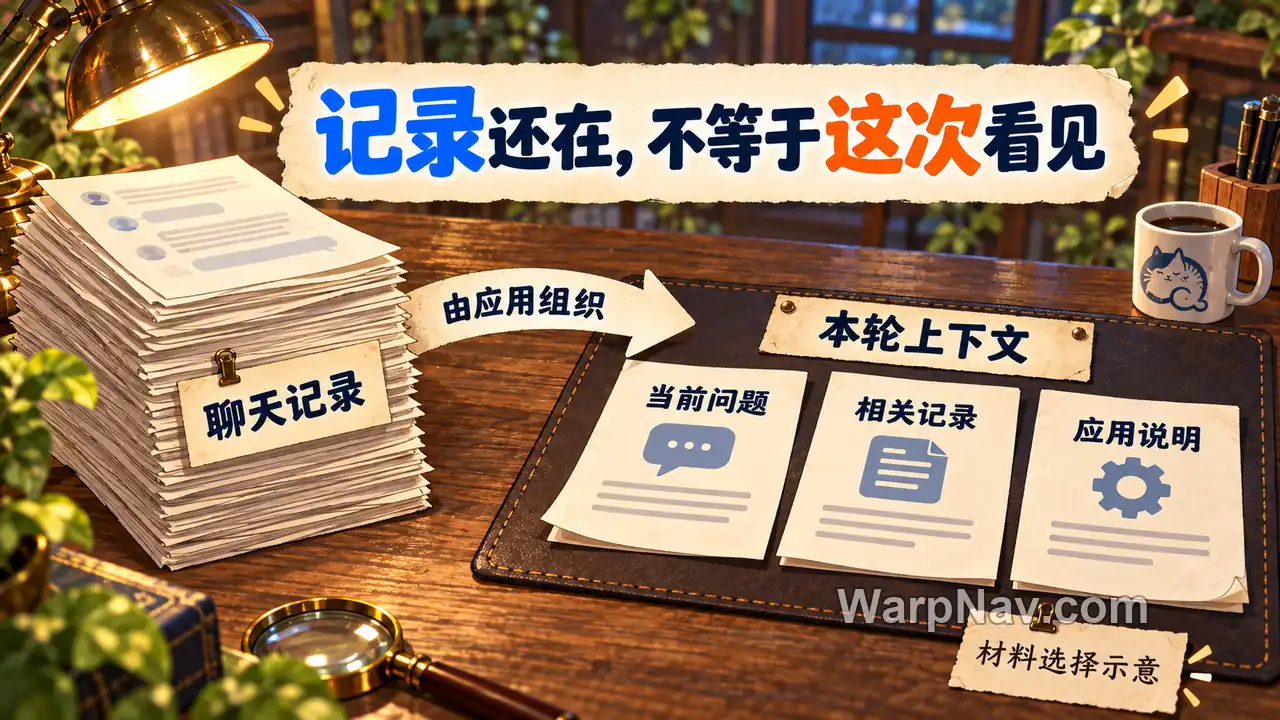
这里容易混淆的是你能在界面里翻到的历史和应用交给模型的本轮输入。聊天应用负责保存、展示记录,也负责组织下一次请求。它可以带上原文,也可以只带一部分、把早期内容压成摘要,或在需要时找回相关片段。具体采用哪种方式,由产品决定。
模型生成下一条回答时,使用的是本轮可用的信息;它不会因为页面还能向上滚动,就自动看见滚动区域里的每一个字。把整段历史存下来,解决的是“记录有没有保存”;把正确内容交给模型,解决的是“这次能不能用上”。
上下文窗口装的是什么?
上下文可以理解为模型回答眼前问题时拿到的材料:你的要求、相关聊天记录、文档内容,以及应用提供的说明等。上下文窗口则是一次处理这些内容的容量边界,通常用 Token 计量。Token 不是固定数量的汉字,具体切分方式可参看Token 与字数的区别。
不妨把当前上下文想成摊在工作台上的材料。聊天历史和文件可能有一大柜子,但这次摊出来的是哪几份,仍要经过选择。工作台变大,可以放更多资料;它并不会自动把柜子里所有东西都摆上来。这个类比说明的是材料的可用范围,不是说模型里面真的有一张桌子。
而且,窗口容量不能直接当成“还能发多少字”。系统说明、工具返回的内容等也会占用空间,许多模型的窗口还需要容纳生成中的回答;不同服务对输入、输出及其他内容的限制并不完全相同。只数自己刚发出的那句话,往往低估了整次请求的长度。
达到限制之后,也没有所有产品通用的“自动忘掉第一句话”规则。服务可能拒绝过长请求,应用也可能先截取历史、生成摘要或要求开启新对话。窗口限制是一回事,产品怎样应对这个限制,是另一回事。
三种情况,都像“失忆”
这次没带上
在活动通知的例子里,如果应用这次只带上了最近几轮改标题的内容,最初的日期和地点就可能不在输入里。新开一个对话后直接说“继续刚才那个”,也存在类似问题:除非产品有相应的跨对话功能并实际取回了资料,否则“刚才那个”并没有清楚地指向一份可用材料。
摘要丢了细节
另一种情况是原文被压缩成了“用户在策划社区活动”。主题留下了,“周日下午、活动室、20 人”却没留下。后续模型收到的是摘要,无法仅靠这句话还原全部原始条件。
摘要不是天然错误,它能腾出空间、保留进度。问题在于,概括得很顺的一段话也可能漏掉决定结果的细节。日期、数字、排除项和已经确认的选择,需要比一般背景得到更多照顾。
带上了,也没用对
即便日期和地点仍在上下文里,模型也可能漏用、混淆或没有遵守。对话中若讨论过多个备选地点,后来又取消其中几个,模型就需要正确分清“提过的方案”和“最后决定的方案”。输入里有答案,不等于输出一定能取对答案。
Google 的长上下文说明指出,寻找多条信息时,准确性会随任务和上下文变化;Anthropic 也提醒,更大的上下文不自动带来更好的信息利用效果。因此,“能放下”与“能准确使用”不能画等号。遇到一次漏信息,仅看聊天界面通常无法确定是哪一种原因,不能直接断言产品偷偷换了模型,或窗口已经耗尽。
长期记忆怎样帮忙?
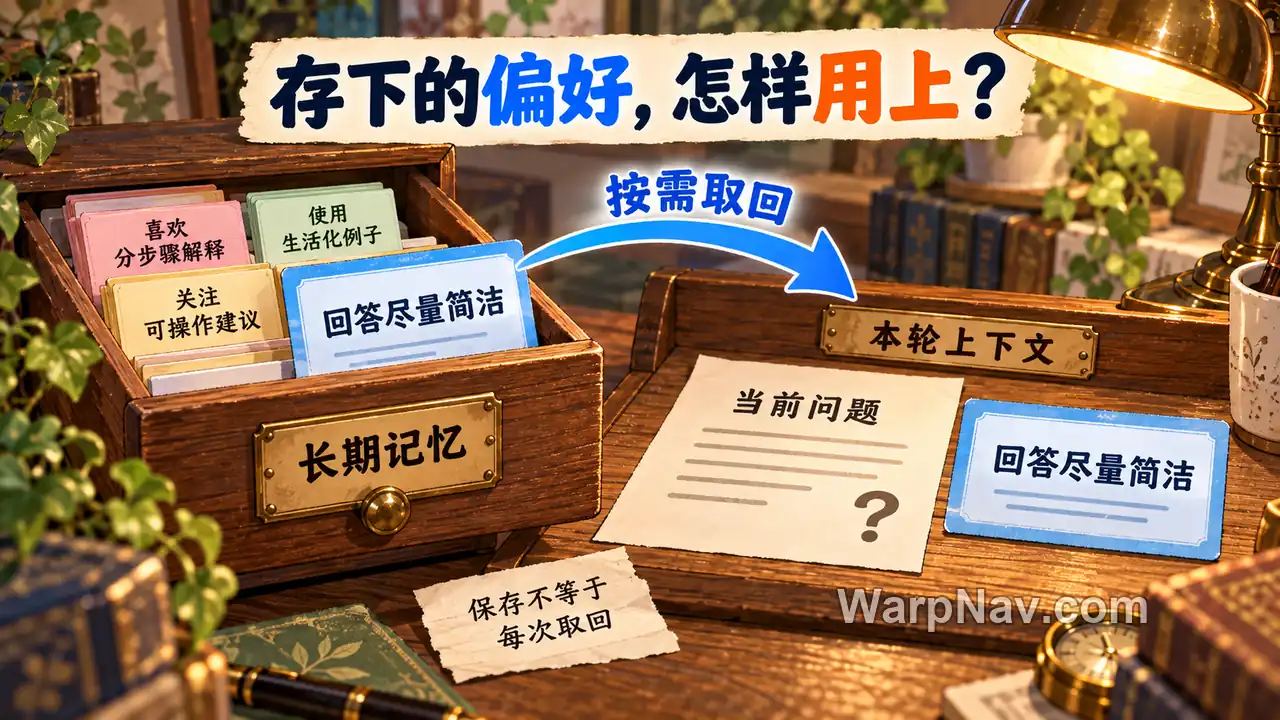
长期记忆解决的是另一个问题:哪些信息值得在当前对话之外继续保存,以后再取出来。比如某个应用保存了“回答尽量简洁”的偏好,未来生成回答时,再把这项偏好提供给模型。
仍用工作台作比喻:上下文是此刻摊开的材料,长期记忆更像另外保存的档案。档案可以留很久,但要对眼前回答产生作用,还得在合适的时候被选中并带回工作台。保存了,不等于每次都取回;取回了,也不等于一定用对。
产品所谓的记忆可能保存偏好、事实摘要或任务记录,并不必然等于逐字保存全部聊天,也不保证所有对话自动互通。具体保存什么、如何管理,应看所用产品的说明。活动日期这样的临时条件,尤其不宜仅靠一句“你应该记得”来传达。
这也不同于训练模型。应用把保存的信息重新交给模型参考,并不表示模型参数已经因这段聊天而改变。关于这层区别,可以接着看聊天、训练与推理的关系。
先核对条件,再决定要不要换对话
如果只是一次漏掉日期,不必立刻搬家。先把正确条件重新写清,并让它直接据此修订。例如:
请按以下已确认条件重写活动通知:周日下午,社区活动室,最多 20 人。此前讨论过的周六和公园方案都已取消。不要自行补充具体钟点,缺少的信息请标为待确认。
接着核对新通知的日期、地点和人数。若这三项已经正确,就可以继续当前任务。AI 回一句“好的,我记住了”还不能证明修正完成,实际生成的内容符合条件,才是可观察的结果。
如果同一对话已经混杂了很多主题、被否决的方案和反复修改的要求,可以整理一份交接材料,再开新对话。先让 AI 按“当前目标、已确认条件、已取消方案、待确认问题、下一步”列出内容,然后自己对照原文检查,尤其是数字和否定条件。不要把未经检查的摘要直接当成正确记录。
活动通知的交接材料可以这样写:
- 目标:完成一份给社区居民看的活动通知。
- 已确认:周日下午,社区活动室,最多 20 人。
- 已取消:周六举办、去公园集合。
- 待确认:具体开始时间和报名联系人,不要编造。
- 下一步:生成可供核对的通知草稿,缺失处标注“待确认”。
把核对后的材料放进新对话;如果还要依据文件原文工作,也应重新提供相关文件或确认该产品确实能够访问它。新对话里的第一版通知,仍按日期、地点、人数和待确认项检查。这样换对话的价值在于减少旧方案与无关内容的干扰,而不是让模型突然拥有更大的记忆。
对于需要持续修改的任务,最好把最终条件留在一份自己能够检查的文档中。对话可以帮助推敲,但“最终定了什么”不应只散落在几十轮聊天里,等下一次回答碰巧找对。
资料依据:
Google:长上下文(上下文范围、使用方式及长上下文限制)
https://ai.google.dev/gemini-api/docs/long-context?hl=zh-cn
Anthropic:上下文窗口(容量与上下文管理)
https://platform.claude.com/docs/zh-CN/build-with-claude/context-windows
Anthropic:Effective context engineering for AI agents(材料选择、压缩与持续任务)
https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
© 版权声明
本站部分内容源于网络收集,文章等版权归原作者所有,若需删稿请联系管理员邮箱:satomini@warpnav.com
相关文章

暂无评论...
