Scrapy
用官方教程站建立分页 Spider
 Crawl4AI
 适合这样一类任务:网页必须由浏览器渲染,抓取规则要进入自己的代码库,原始 HTML、Markdown、链接、媒体和结构化字段也要由自己决定怎样保存。它是开源 Python 框架,不是托管的“粘贴网址即返回正文”服务;安装浏览器依赖、控制并发和处理升级兼容,都是选择自托管后需要承担的成本。
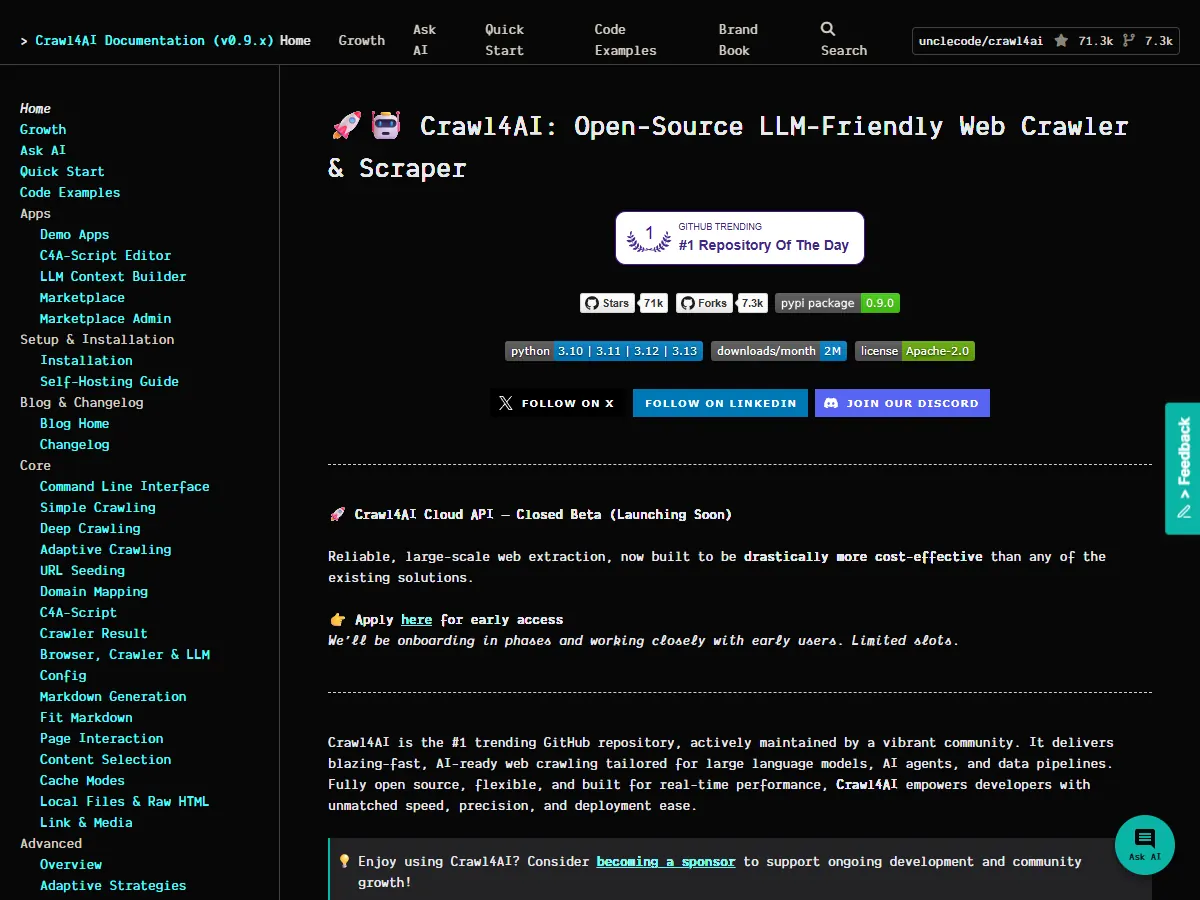
官方 v0.9.x 文档把 AsyncWebCrawler 作为核心入口;截至 2026-09-16,GitHub 最新 Release 为 v0.9.3,核心仓库采用 Apache-2.0。若只是偶尔读取一篇公开文章,托管 Reader 往往更省维护;当页面依赖 JavaScript、需要固定代理或 User-Agent、要保留内部链接和媒体、或必须把数据留在自己的运行环境中,Crawl4AI 才显示出优势。
项目另有仍标为 Closed Beta 的 Cloud API,不能与本地开源库混写成已经稳定公开计费的 SaaS。Docker 在安装文档中也仍带实验性说明。选择本地版意味着浏览器更新、日志、任务队列和失败恢复由使用者承担;外部代理和 LLM 提供商仍可能产生费用。
先运行 pip install crawl4ai,再执行 crawl4ai-setup 安装或更新浏览器依赖;crawl4ai-doctor 可检查 Python、Playwright 与环境冲突。只有需要语义分块等扩展时才安装 crawl4ai[torch]、[transformer] 或 [all],基础抓取不必先承担这些额外依赖。
官方基础示例把浏览器级设置和单页抓取设置分开:
browser_config = BrowserConfig()
run_config = CrawlerRunConfig()
async with AsyncWebCrawler(config=browser_config) as crawler:
result = await crawler.arun(url="https://example.com", config=run_config)
BrowserConfig 决定浏览器如何启动,例如 headless、浏览器类型、User-Agent 和日志;CrawlerRunConfig 决定这一次请求怎样缓存、等待、过滤和提取。旧代码仍可能把 css_selector 等参数直接传进 arun(),当前文档明确建议迁移到 CrawlerRunConfig,否则多页面任务很难确认每个 URL 实际用了哪套策略。
不写 Python 也可用 CLI:crwl https://example.com -o markdown --bypass-cache。命令输出应包含 example.com 的正文,而不是空文件或浏览器错误;CLI 还可选择 markdown-fit、json 和 all。
请求完成后先看 result.success、result.status_code 和失败时的 error_message。成功结果还包括:
html:原始 HTML;cleaned_html:清理后的 HTML。markdown.raw_markdown 与 markdown.fit_markdown:前者保留清理后内容,后者经过相关性过滤。links["internal"] / links["external"]:站内与站外链接。media["images"] 等媒体信息。如果 success 为真但 fit_markdown 几乎为空,应先比较 raw_markdown,确认是不是过滤器阈值过高;如果状态码或标题对不上目标页,则不能把“有字符串返回”当作抓取成功。
列表页 DOM 稳定时,JsonCssExtractionStrategy 比 LLM 提取更便宜且可重复。官方示例的 schema 有两个核心部分:baseSelector 指向每个重复容器,fields 为容器内的字段定义 name、selector 和 type。例如每行是 div.crypto-row,内部用 h2.coin-name 和 span.coin-price 取名称与价格;策略放进 CrawlerRunConfig(extraction_strategy=...),结果从 json.loads(result.extracted_content) 读取。
字段还可用 attribute、html、regex,以及 nested、list、nested_list 处理层级数据。官方也提供 raw:// 方式把本地 HTML 交给 XPath 策略测试,这比反复请求线上页面更适合调 schema。
页面缺少晚加载内容时,再在 RunConfig 中加入 wait_for、js_code 或页面扫描;弹窗和导航噪声可用 remove_overlay_elements、excluded_tags、css_selector 等处理。单页字段稳定后才用 arun_many,并按本机与目标站承受能力限制并发。更复杂的 Hook、会话复用和代理配置可继续查阅项目的完整官方文档。