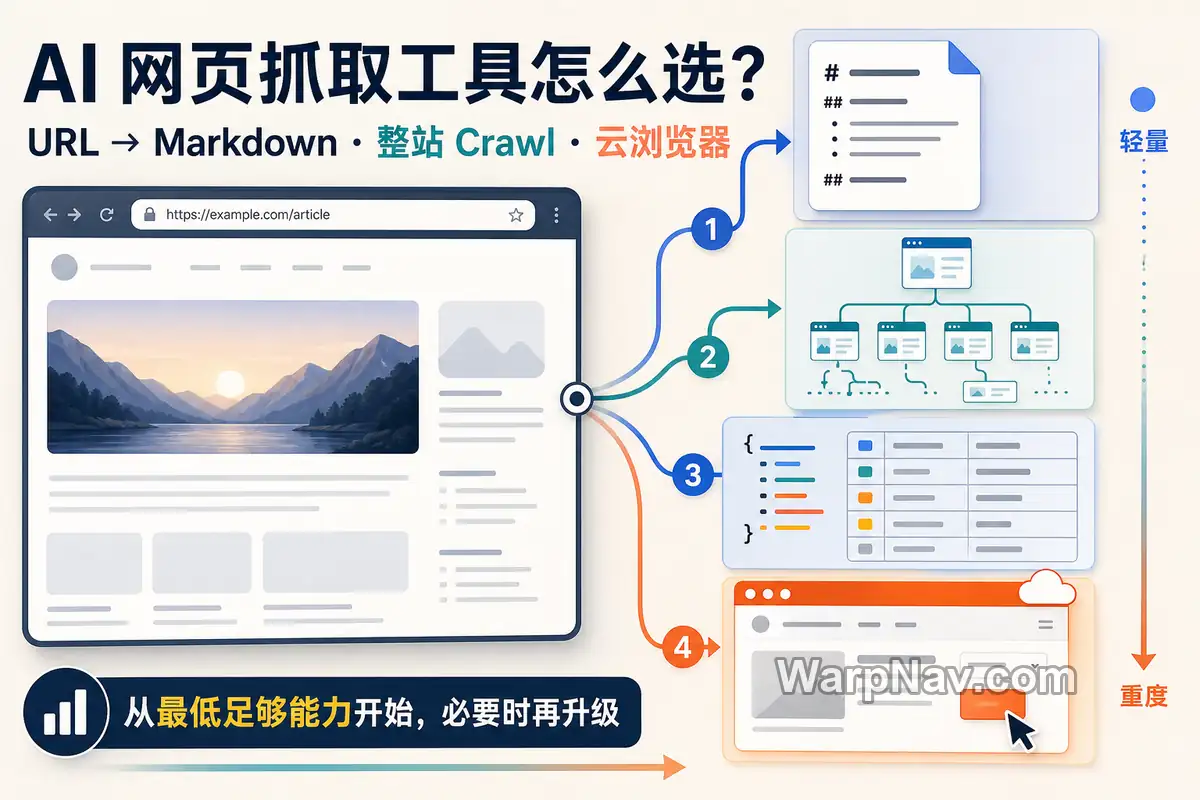
AI 网页抓取工具怎么选,第一步不是列品牌,而是确认网页数据任务需要的最低能力:一个已知 URL 的干净文本、同站多页发现、固定字段提取、需要交互的真实浏览器,还是可以长期维护的数据管线。Reader 足够时不要先启动浏览器,单页足够时也不要直接整站 Crawl。本文按任务层级比较代表工具,并给出一套可复用的试用合同。
核验边界:本文依据截至 2026 年 8 月 13 日可访问的官网和官方文档整理。产品端点、套餐、免费额度和浏览器能力变化较快,因此不提供静态价格表,也不声称已经完成统一性能实测。所有抓取都应建立在公开访问、站点条款和合法授权之上。
先选能力层
| 当前任务 | 最低必要能力 | 先试路线 | 何时升级 |
|---|---|---|---|
| 读取一个已知公开 URL | 正文清洗、Markdown 或 JSON | Reader / Fetch | 正文依赖 JavaScript、登录态或交互 |
| 导入文档站或知识库 | URL 发现、路径过滤、多页 Crawl | Map + Crawl | 需要定时更新、去重和失败恢复 |
| 提取产品、职位或列表字段 | Schema、CSS/XPath 或自然语言 Extract | 结构化提取 | 页面结构变化频繁或字段藏在交互后 |
| 页面必须点击、滚动或维持会话 | 真实浏览器 Session | 云浏览器或浏览器自动化 | 需要并发池、代理、录制和调试 |
| 长期、敏感或大规模管线 | 部署、监控、预算与数据边界 | 托管 API / 自托管评估 | 单次调用成本不再代表总成本 |
这些是默认强项,不是永久产品分类。Firecrawl、Tavily、Hyperbrowser、Browserbase 和 ScrapeGraphAI 等产品已经横跨多个层级;真正应比较的是完成当前任务的默认路径、需要自己承担的工程责任,以及失败后能否定位原因。
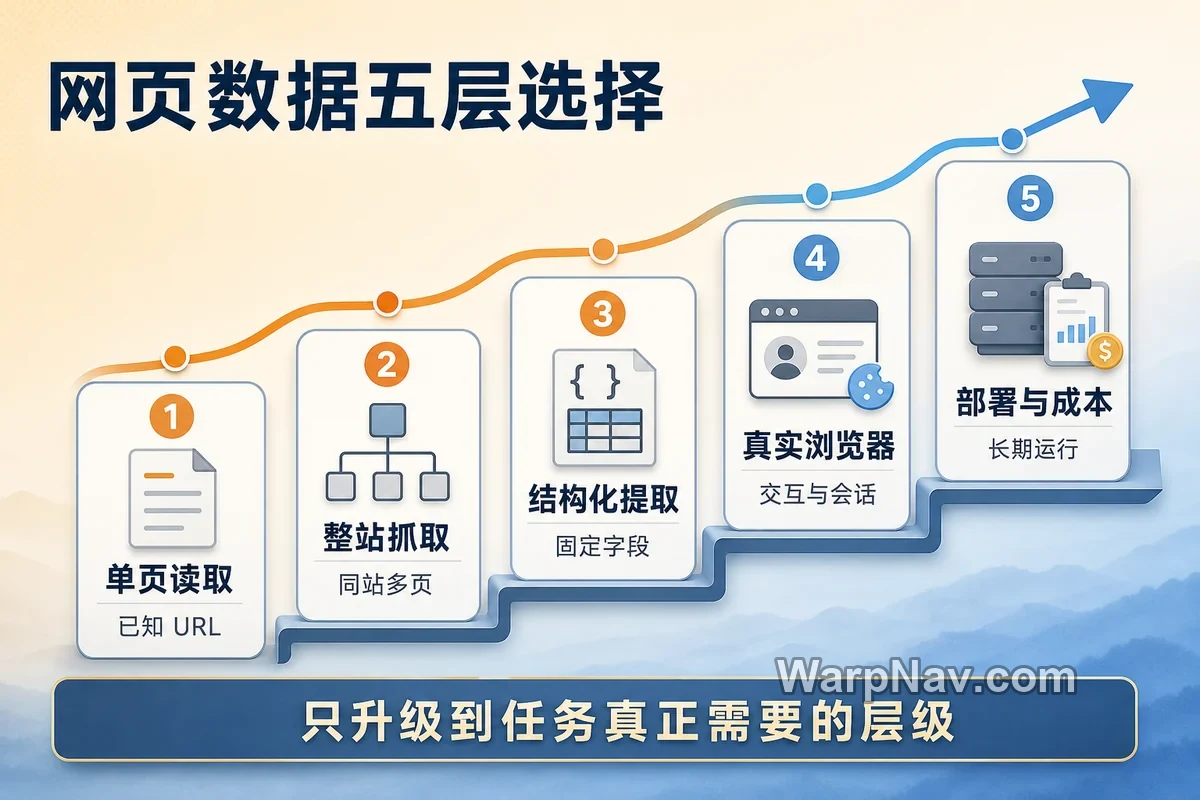
工具并非同类
单页读取
当输入是一个公开 URL,目标只是让模型获得正文、标题、链接和较少噪声时,轻量 Reader 往往最省事。Jina Reader API适合网页转 Markdown 或 JSON 的单页路径;它不应被当成需要登录、复杂交互和大规模调度时的完整浏览器平台。

站点发现与抓取
文档站、帮助中心或博客导入需要先发现 URL,再限制路径、深度、页数和重复规则。FireCrawl提供 Search、Scrape、Map、Crawl 与提取入口;Tavily把 Search、Extract、Map、Crawl 与 Research 放在统一 API 中。两者都能覆盖多步任务,但不代表每次都要从 Crawl 开始。
结构化提取
如果目标不是全文,而是产品名、价格、职位、日期或其他固定字段,需要比较 Schema、选择器、字段缺失处理与证据 URL。ScrapeGraphAI更强调自然语言与 LLM 驱动的结构化流程;Diffbot更靠近页面识别、结构化抽取、Crawl 与 Knowledge Graph 路线。选择前先准备明确字段表,不要让模型自行猜测什么信息重要。
真实浏览器
只有内容确实依赖 JavaScript、点击、滚动、会话状态或多步骤操作时,才需要升级到浏览器层。Browserbase和Hyperbrowser都能承接浏览器会话与 Agent 执行,但还要评估 Session 调试、Profile/Cookie、并发、代理、录制和数据保留。

十个代表工具
| 工具 | 默认起点 | 更适合 | 选择前确认 |
|---|---|---|---|
| Jina Reader | 公开 URL 转 Markdown/JSON | 摘要、问答、轻量入库 | 页面是否公开、输出是否完整 |
| Firecrawl | Search/Scrape/Map/Crawl 统一入口 | 文档导入、Agent 网页数据 | 端点选择、托管与自托管边界 |
| Tavily | 搜索与网页访问 API | 实时 Agent、RAG、研究 | Search/Extract/Crawl/Research 不混用 |
| Crawl4AI | 自托管可编程抓取 | 需要本地控制与深度 Crawl | 部署、安全、升级与监控责任 |
| ScrapeGraphAI | LLM 驱动字段提取 | 自然语言 Schema 与监测 | 字段证据、缺失与版本端点 |
| ScrapingBee | 托管抓取、JS 渲染与代理 | 不自建浏览器和代理层 | 区域、交互、失败重试和费用 |
| Zyte | 托管抓取与自动结构化提取 | 企业采集与浏览器内容 | 输出类型、自动提取覆盖与数据政策 |
| Browserbase | 可观测浏览器 Session | Agent 操作、调试和状态任务 | Profile、凭据、并发与录制 |
| Hyperbrowser | 浏览器会话与 Web API | Fetch/Crawl/Search 到交互升级 | 何时需要浏览器而非轻量端点 |
| Diffbot | 页面识别与知识图谱 | 企业结构化数据和大范围 Crawl | 数据模型、覆盖、成本与引用 |
主表只承担定位,不替代各产品页。需要深入 Firecrawl 的开源实现与接口边界,可继续看Firecrawl 项目介绍;希望比较更偏自适应、开源爬虫框架的路线,可参考Scrapling 项目介绍。它们是邻接入口,不与本文争夺“工具层怎么选”的中心意图。
托管还是自托管
托管 API 把浏览器、代理、队列、扩缩容和部分失败恢复交给服务商,适合快速验证和团队不希望维护基础设施的场景。自托管框架给出更强的数据位置、依赖与运行控制,但服务器、浏览器版本、安全补丁、代理质量、监控和升级都变成自己的责任。
- 先算任务量:记录每月 URL、页面复杂度、动态页面比例和失败重试,不只看单次调用价。
- 再算运维:把机器、容器、浏览器池、代理、日志、告警和升级时间计入总成本。
- 检查数据位置:URL、Cookie、页面正文和提取结果是否允许发送到第三方。
- 保留退出路径:输出使用通用字段并保存来源 URL,避免把知识库绑定在某个短期端点上。
需要本地控制时,Crawl4AI 是代表性起点;需要可复用的站点专用采集器、调度和数据集时,Apify的 Actor 路线也值得作为邻接方案评估,但它不进入本文十款主表。
统一试用合同
没有在相同样本上运行,就不能写“谁更快、谁成功率更高”。稳妥做法是先制定同一份任务合同,让每个候选处理相同 URL、字段和停止条件,再比较可交付结果。
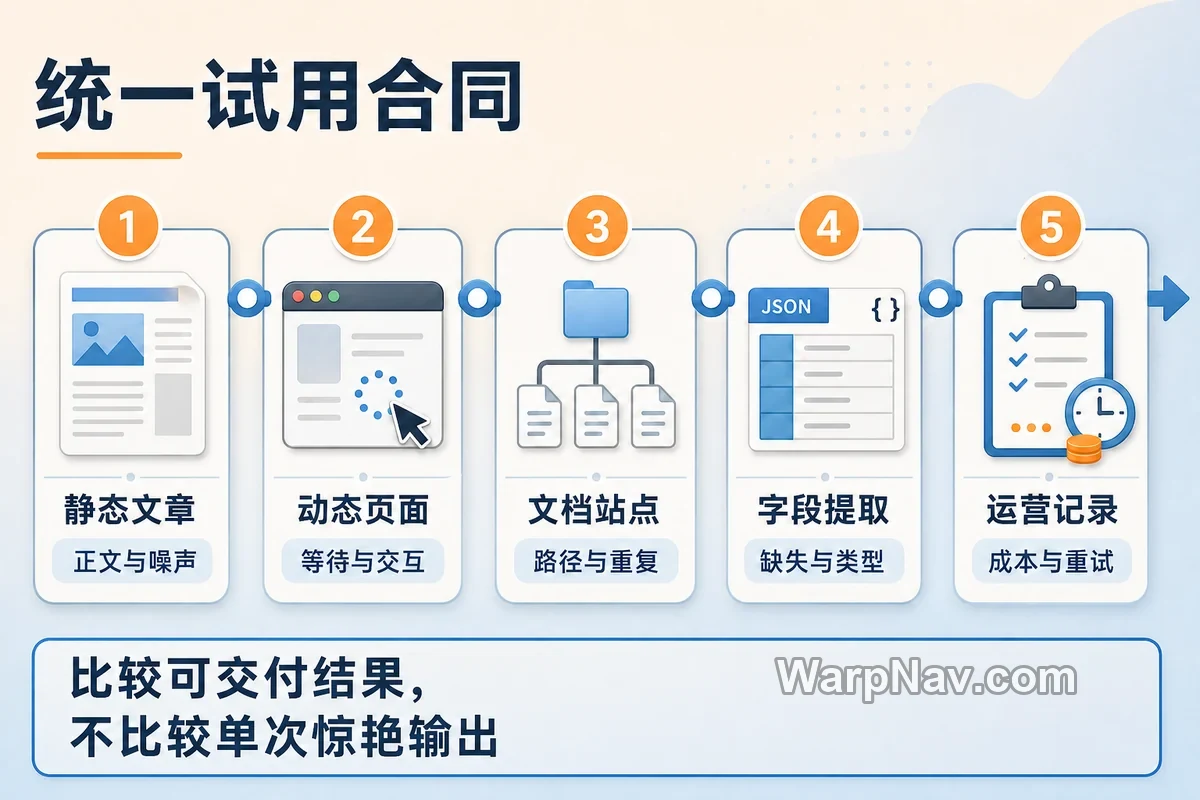
- 静态文章:检查正文完整性、标题层级、链接、发布日期与导航噪声。
- JavaScript 页面:记录关键内容是否需要等待、滚动、点击或登录。
- 文档站:限定路径、深度和页数,记录重复 URL、语言版本、失败页与更新时间。
- 结构化任务:给定字段类型,记录缺失、类型错误、证据 URL 和重试一致性。
- 运营记录:统计单页费用、失败重试、人工修正、日志可见性和总处理时间。
最终表格应同时保留成功和失败样本。一次漂亮输出不能代表生产稳定性;如果没有完成这套测试,只能写“建议怎样验证”,不能把官网案例改写成实测结论。
四类场景
RAG 知识库
先区分一次性导入与持续同步。一次性公开文档可从 Reader 或 Map/Crawl 开始;持续更新还需要 canonical 去重、更新时间、删除页面处理、分块和来源引用。网页抓取层不会替代向量库、Embedding 或检索质量评估。
AI 智能体
实时回答通常先 Search,再对少量结果 Extract;只有任务真的需要页面操作时才启动浏览器。把网页内容视为不可信输入,隔离页面中的提示注入,限制工具权限,并要求模型保留证据 URL。
页面监测
监测价格、职位或政策页面时,重点不是把全文每天保存一次,而是字段稳定、变更证据、抓取频率与误报。先判断页面是否提供 RSS、API 或官方数据出口;有更稳定来源时,不应默认用浏览器抓取。
企业数据
企业采购还要检查合同、数据处理位置、日志与保留期、SLA、访问控制和供应商退出方案。敏感数据场景中,技术上可抓取不等于组织上允许处理。
合规与安全
- 遵守目标网站的访问政策、服务条款、robots 和合理频率,不提供绕过验证码、登录或付费墙的方法。
- 不批量收集无明确目的的个人信息;涉及个人数据时执行最小化、保留期限和访问权限。
- Cookie、会话和 API Key 只进入受控密钥系统,不放在提示词、截图、前端代码或普通日志里。
- 保留来源 URL、抓取日期和失败记录,让知识库内容可以追溯和删除。
- 第三方网页可能包含恶意脚本或提示注入;Agent 不应因页面文字自动扩大权限或执行外部动作。
最后如何决定
把短名单收敛到两项:一项是能完成当前任务的最低能力路线,另一项代表不同的责任边界。例如单页 RAG 可比较 Jina Reader 与一个托管统一入口;文档站可比较 Firecrawl/Tavily 与 Crawl4AI;需要真实交互时再比较 Browserbase 与 Hyperbrowser。两项都运行同一试用合同后,再按输出完整度、失败定位、维护责任、数据边界和真实总成本决定。
市场会继续变化,但这个选择顺序相对稳定:先确定输出,再选最低能力;先限制范围,再扩大 Crawl;先验证普通读取,再升级浏览器;最后才比较长期托管或自托管。这样得到的不是一张很快过期的榜单,而是一套能随产品更新继续使用的决策方法。
主要核验资料:Firecrawl 文档 https://docs.firecrawl.dev/introduction;Jina Reader https://jina.ai/reader/;Crawl4AI 文档 https://docs.crawl4ai.com/core/quickstart/;ScrapeGraphAI API https://docs.scrapegraphai.com/api-reference/introduction;ScrapingBee 文档 https://www.scrapingbee.com/documentation/;Zyte API https://docs.zyte.com/zyte-api/usage/reference.html;Browserbase 文档 https://docs.browserbase.com/welcome/introduction;Hyperbrowser Web API https://www.hyperbrowser.ai/docs/web/overview;Diffbot Analyze https://docs.diffbot.com/reference/extract-analyze;Tavily API https://docs.tavily.com/documentation/api-reference/introduction。
© 版权声明
本站部分内容源于网络收集,文章等版权归原作者所有,若需删稿请联系管理员邮箱:satomini@warpnav.com
相关文章



暂无评论...
