Our World in Data
从互动图表追溯数据、处理说明与引用来源
 Data Commons
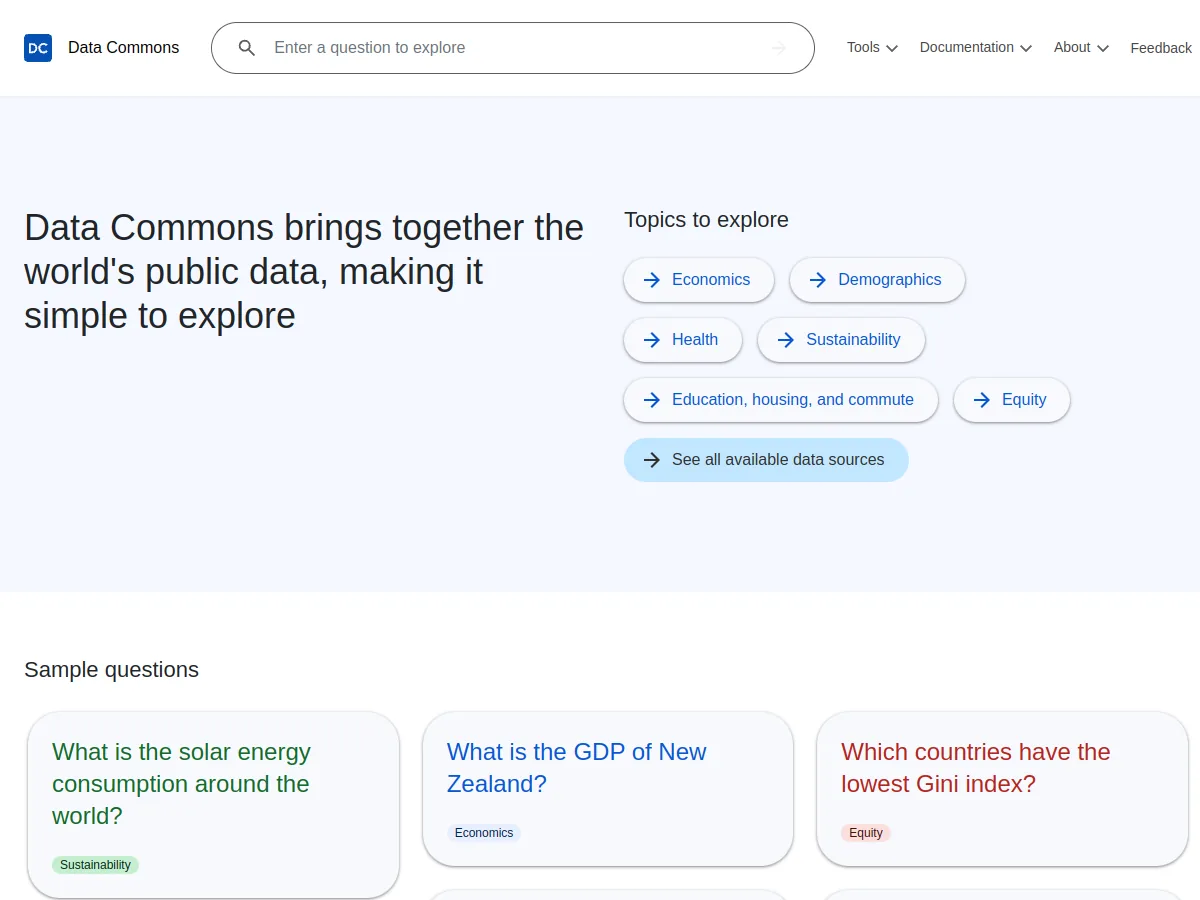
 把多个公共来源的数据映射到统一知识图谱,核心不是“搜索到一个数字”,而是把地点或其他实体、统计变量、日期、观测值和来源关系连接起来。快速浏览可使用地点页与可视化工具;要把数字用于报告、新闻或产品,必须继续核对 Statistical Variable、Facet 和上游数据来源。
Data Commons 用 DCID 标识图谱节点。一个统计问题通常由三部分组成:实体,例如美国或某座城市;Statistical Variable(StatVar),例如 Total Population 或更细的人群指标;日期,例如 2020 或最新可用值。Observation 则是某个实体在特定日期下对某个变量的观测值。
自然语言搜索适合发现可能的变量和地点,但正式分析应记录 DCID 与 StatVar DCID,因为相似中文或英文名称可能对应不同统计口径。
同一实体和变量可能同时存在多个 Facet,分别来自不同数据集、来源机构或测量方法。Observation API 默认可以返回全部可用分面,这意味着结果中可能混合不同来源或方法。读取时间序列时应查看 facetId、provenanceUrl、measurementMethod、observationPeriod、unit 和 scaling_factor,需要连续口径时用 facet filter 固定来源。
| 字段 | 为什么影响结论 |
|---|---|
| earliestDate / latestDate | 判断不同地区的时间覆盖是否重叠 |
| obsCount | 发现序列是否只有零散年份 |
| measurementMethod | 区分调查、估算或其他采集方式 |
| unit / scaling_factor | 避免把百分比、比例和绝对数量直接比较 |
| provenanceUrl | 回到上游机构核对定义、修订和引用要求 |
Data Download Tool 适合不写代码的批量导出。先输入地点,再选择要向下拆分的地点类型;左侧最多选择 5 个 StatVar;日期可选最新、全部或自定义范围。预览无误后导出的 CSV 会按地点和日期逐行给出 placeDcid、placeName、Date、Value 与 Source 等字段。
开发者可使用 REST v2 或 Python 客户端。Observation API 以变量 DCID、实体 DCID 或实体表达式、日期和可选 Facet 过滤器组成请求;LATEST 只取各实体与来源的最新值,空日期表达式可请求全部日期。正式调用需要 API Key,应保存在服务端环境变量,不放进前端代码、仓库或公开链接。
上线前应固定变量和 Facet、保存原始响应、处理分页或缺值,并为上游修订留出重新计算路径。Data Commons 的统一模型减少了跨来源连接成本,却不会消除来源定义、更新频率和测量方法的差异。探索入口:https://datacommons.org/explore;API 文档:https://docs.datacommons.org/api/





