
AMiner
AI 论文检索、文献阅读与学者关系平台
 Elicit
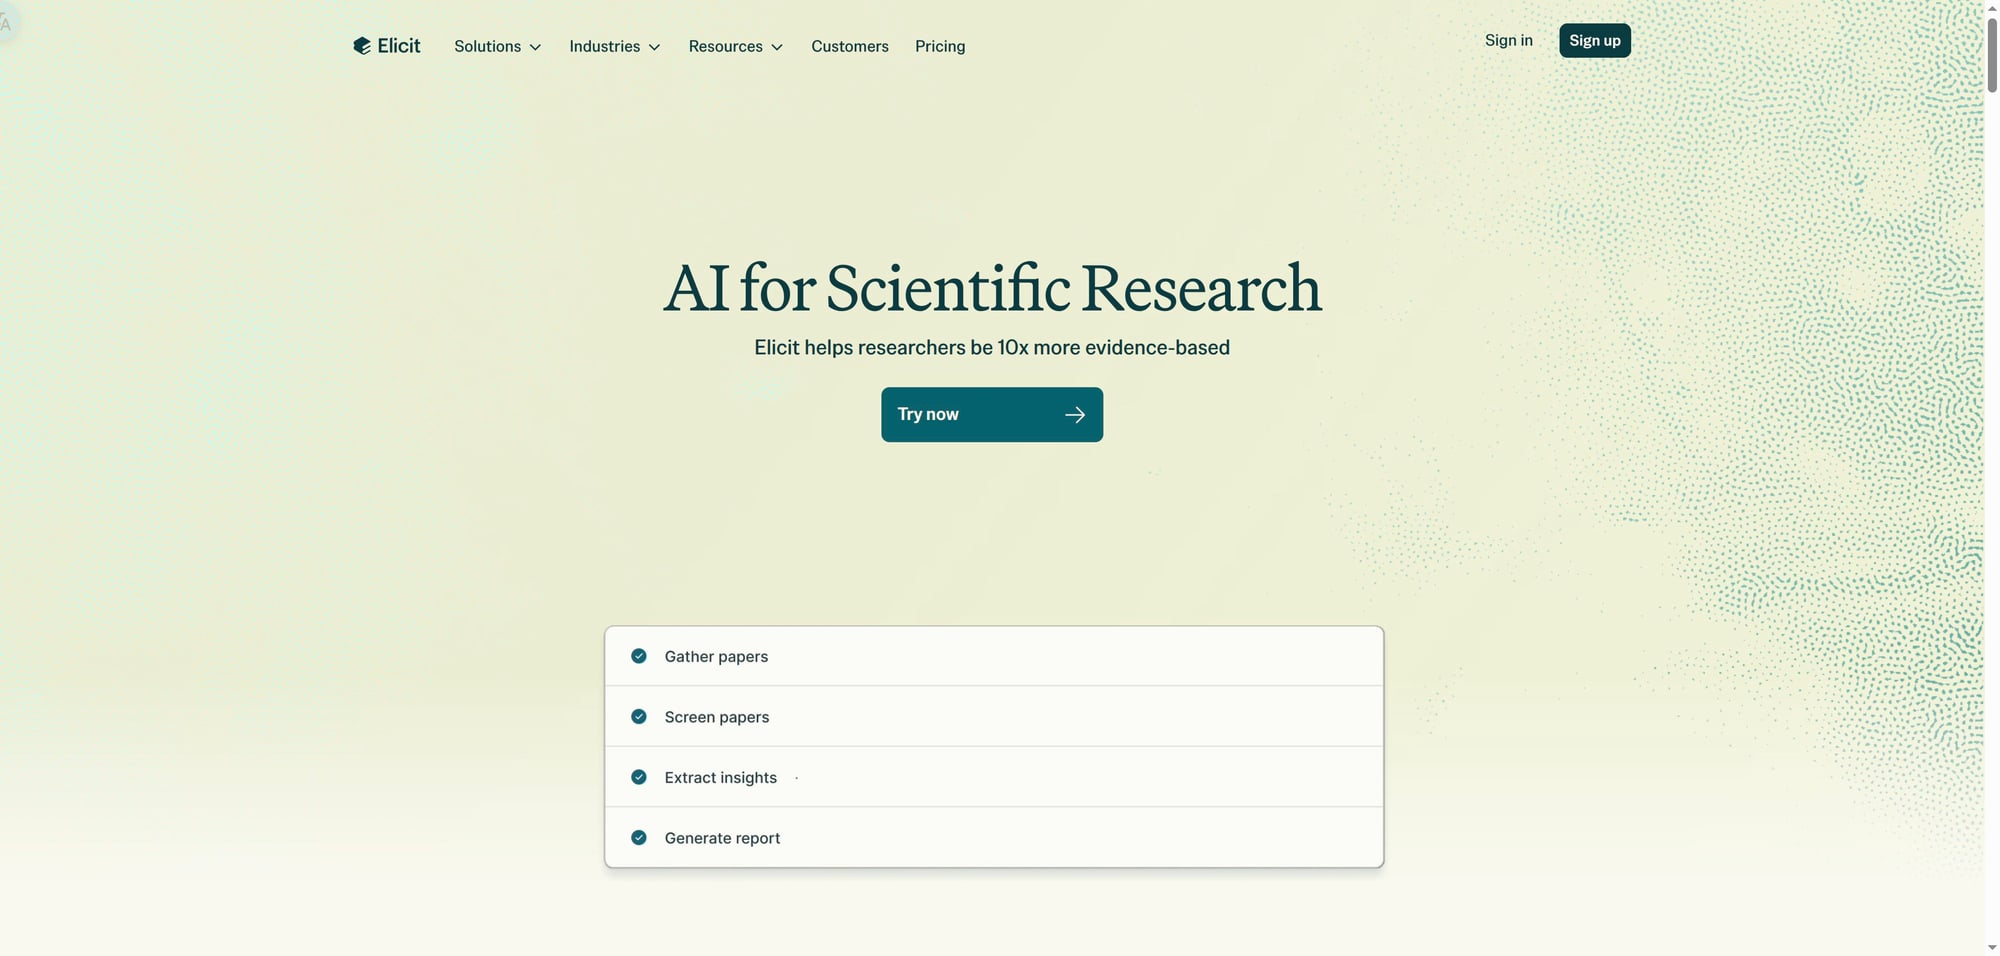
 作为专为实证研究人员与科研团队打造的 AI 文献分析引擎,彻底打破了传统基于关键词布尔检索的浅层匹配局限。平台通过底层语义嵌入与学术大语言模型微调技术,将海量文献检索、摘要提炼、实验变量抽取与多维证据整合串联为一体化科研辅助工作流,显著降低了前期文献调研与系统评价的筛选耗时,为循证研究提供了系统化的数字化基础设施。
在传统的文献检索过程中,研究人员往往受制于特定同义词表达与学科术语壁垒,极易遗漏高价值研究成果。Elicit 基于两亿余篇学术论文语料库构建语义检索网络,允许科研人员直接输入具体的科研问题或实证假设。系统首先通过高维向量对齐解析问题的核心实证意图,进而从标题、摘要及全文片段中挖掘深层上下文语义关联。在完成初筛召回后,平台内置的交叉注意力排序算法会根据文献的研究类型、发表年份、引用权重及研究相关度展开多级重排,优先呈现实证严谨度高、实验设计规范的高相关同行评审论文,避免了无关综述的干扰。
文献综述工作的核心痛点在于跨论文关键字段的手工摘录与对齐比较。Elicit 提供了高度可定制的结构化提取工作流,能够自动化解析非结构化 PDF 文本,并将关键研究要素转化为标准表格视图。在构建文献综述时,科研人员可依托下表所示的四维证据抽取框架展开横向透视,实现对研究全貌的立体把控:
| 抽取分析维度 | 技术解析重点与提取目标 | 科研实证价值与评估指标 | 人工复核与风险防范注意点 |
|---|---|---|---|
| 研究设计与对象 | 随机对照实验、观察性队列、横断面调查及受试样本基线特征 | 确认证据等级与外部效度,识别样本偏倚与纳入排除标准合规性 | 核验样本损耗率与对照组设置是否真实匹配实验方案 |
| 样本容量与功效 | 统计功效分析、样本量测算依据、多中心分布与亚组规模统计 | 评估统计推断可信度与结果检验力,防范小样本假阳性结论 | 防范统计显著性与实际临床或实践显著性产生混淆 |
| 干预手段与控制 | 自变量操作化定义、干预周期、安慰剂对照机制与实施保真度 | 厘清因果关系推断链路,排除潜在混杂变量对实验效应的干扰 | 审查干预实施细节是否存在未受控制的系统性混杂变量 |
| 效应量与核心指标 | 主效应量比值比、置信区间、多重检验校正显著性及测量量表 | 获取元分析合并效应量基础输入,量化实证干预的实际作用幅度 | 核对原著统计表格与正文描述数值是否完全一致 |
通过上述标准化提取,研究人员无需逐篇查阅冗长论文即可掌握各文献间的研究范式差异,极大加速了跨文献结论对比、方法论审视与证据收敛进程。
针对长篇论文中的复杂推导与实验细节,Elicit 支持针对单篇或选定文献集合发起交互式深度提问。系统采用检索增强生成架构,在响应科研问答时强制绑定原文具体段落与页码坐标。当研究人员追问实验操作细节、模型超参数设置或敏感性分析结果时,系统仅依据原文实证内容组织论述,并在生成答案中实时标注可点击回溯的原文锚点。这种透明化的证据呈现机制,从技术根源上有效遏制了大语言模型的幻觉问题,使科研人员能够快速透视论文深层逻辑与技术细节,确保推论有据可依。
尽管 Elicit 具备强大的信息提取与聚合能力,但科研人员必须明确其辅助工具定位,严守学术实证严谨性红线。大语言模型在提取复杂统计表格、嵌套图表数据及否定语态结论时,仍可能存在漏检或语境断章取义风险。因此,自动生成的证据矩阵绝不能直接替代系统评价与荟萃分析中 PRISMA 等规范要求的独立双盲人工筛查流程。在撰写正式学位论文、国家课题申请书或同行评审期刊文章时,所有由平台抽取的效应值、样本量及结论表述,均须研究人员手工回溯至原始 PDF 进行终审核验,杜绝未经验证的二手证据引用流入正式学术成果。