
Hermes Agent
开源端侧自主智能体,支持本地模型接入与 Docker 隔离沙盒。
 FastGPT
 是围绕知识库问答、工作流和 Agent 构建 AI 应用的平台,适合把产品文档、内部制度或业务资料接入模型,再通过网页或接口提供服务。它的价值不只是上传文件后得到一个聊天窗口,而是让资料处理、检索、提示词和后续工具调用能够被分别配置与检查。对于文档问答,最先要做好的通常是“找到了哪段材料”,而不是让回答听起来更流畅。
官方快速入门将普通对话、知识库问答、工作流和 Agent 编排分成不同案例。第一次处理内部资料时,可以先用小范围文档验证检索链路,不必直接把整个文件盘导入。模型负责生成回答,向量模型承担文本表示;自建环境需要先配置相应服务,不能仅凭上传完成判断应用已经具备问答条件。
文档中的操作路径是新建 Dataset,再创建 Text Collection,上传本地文件,检查解析和分段结果,等待处理状态就绪。随后在 Studio 新建 Conversational Agent,关联知识库,并设置回答要求。不同版本的界面语言可能不同,但“资料入库”和“应用关联资料”是两步。
例如自拟一份会议室说明,包含“提前一天预约”“使用后整理桌椅”“设备故障联系行政”三条规则。先用 TXT 或 Markdown 保持结构简单,再看分段中是否保留完整规则及其标题。复杂 PDF 的解析还取决于所配解析能力,不能把扫描图片与可直接提取文本的文档视为同一种输入。
分段过大,会把多个不相关事项一起带入回答;过小,又可能将条件与结论拆开。例如“提前一天预约”若与“仅适用于大会议室”分属不同片段,召回前一句时就可能丢掉适用范围。检查重点应是规则能否独立理解,而不是机械追求更短的片段。
可以先问“会议室需要提前多久预约”,再问“周末使用是否收费”。后者在上述样本中没有依据,应明确表示材料未说明,而不是补出收费规则。提示词可以要求依据知识库回答、给出来源、缺少信息时说明缺口;这些约束有帮助,但并不构成不会产生错误答案的保证。
检查时同时看返回答案与引用片段:引用是否真的包含结论,是否漏掉限定条件,是否拿到了旧版文件。样本文档和问题是配置示例,不是本页实际运行过的测试结果。将这种小样本检查通过后再扩大资料范围,通常更容易定位问题来自导入、检索还是回答生成。
| 机制 | 主要解决的问题 | 适合关注的情况 |
|---|---|---|
| 语义检索 | 按含义寻找相关片段 | 用户换了一种问法,没有使用原文词语 |
| 全文检索 | 利用文本中的关键词匹配 | 型号、专有名称等需要精确词项的内容 |
| 混合检索 | 结合多路召回结果 | 既有自然语言问题,也有明确术语的资料 |
| 重排 | 对候选片段重新计算相关性并排序 | 已经召回内容,但靠前结果不够贴题 |
官方知识库引擎说明中,混合结果的 RRF 融合与重排是不同环节。重排无法凭空补出未入库的信息,也不能修复原文规则本身的矛盾。多开一个模型环节还会改变延迟和资源消耗,应围绕自己的问题样本判断收益。
没有召回结果时,先确认数据处理已完成、应用关联了正确知识库,再检查问题表达和最低相关度设置。阈值过高可能过滤掉有用片段;阈值放低后虽然返回更多内容,也可能混入干扰。官方说明还指出,相关度设置的作用与所选检索、重排方式有关,不能把同一个数字当作跨方案通用质量分。
引用上限按 Token 预算控制,不是简单的“最多返回几条”。如果多个相关片段共同解释一项制度,预算过小可能截断证据;如果召回大量边缘内容,则应回到分段和检索配置,而不只是不断扩大上限。
用户追问“第二点怎么办”时,单独检索这句话往往缺少主题。查询改写用于结合上下文补足检索问题,但会增加模型调用与等待。应查看改写后的含义有没有偏离原问题,再决定是否启用,而不是将其视为所有知识库都必须打开的选项。
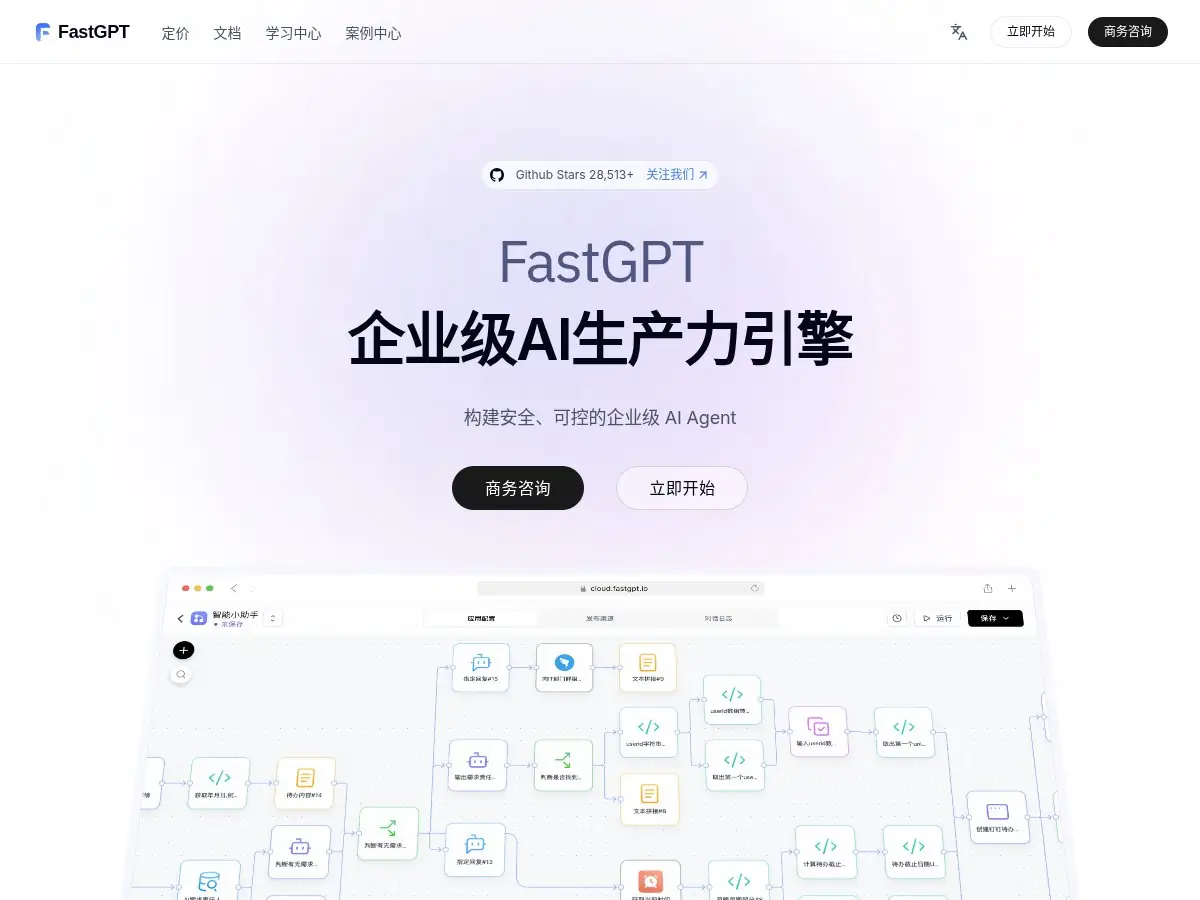
当需求变成“先判断问题类别,再检索资料,必要时调用外部服务”,工作流比单个问答提示词更合适。FastGPT 提供模型、知识库、工具及 Agent 编排能力,可以把输入、分支和处理结果组织起来。产品支持、员工制度查询与资料初审是不同任务,应该分别定义输入和交付,而不是共用一个无边界的全能助手。
例如产品支持流程可先识别用户提供的型号,再检索对应说明,材料缺失时返回需要补充的信息;涉及业务写入的工具则应另设权限与确认。调试时沿运行记录查看每一步的输入输出,能够区分“型号没提取出来”和“文档没有这个型号”,避免所有失败都归因于模型不够强。
官网同时提供企业咨询、验证与实施服务。是否需要这些服务,取决于数据接入、权限和运维责任,不应直接套用官网行业案例中的效率数字。若还在比较不同搭建方式,可结合AI Agent 平台选型指南理解知识库平台与其他编排工具的侧重点。
云服务方便开始,自建则需要负责模型接口、数据存储、访问控制和升级维护。企业介绍中的 SSO、角色权限等能力不能据此认定都属于任意开源部署的默认配置。官方 SSO 文档明确涉及 fastgpt-pro 和独立适配服务;其支持表中,LDAP 用于成员同步,并未标为 SSO 登录支持。
截至 2026 年 9 月 16 日,官方仓库采用带附加条件的 Apache 2.0 许可文本。内部平台或后端服务的商业使用,与提供类似产品的多租户 SaaS 并不是同一许可场景:后者需要书面商业授权;控制台标识及版权信息也有保留要求。准备二次开发、对外提供服务时,应阅读所用版本的完整 LICENSE,而不是只看到“开源”就推断没有商业边界。