清影AI
基于CogVideoX大模型与两阶段超分技术落地高质感AI影视分镜
 pyVideoTrans
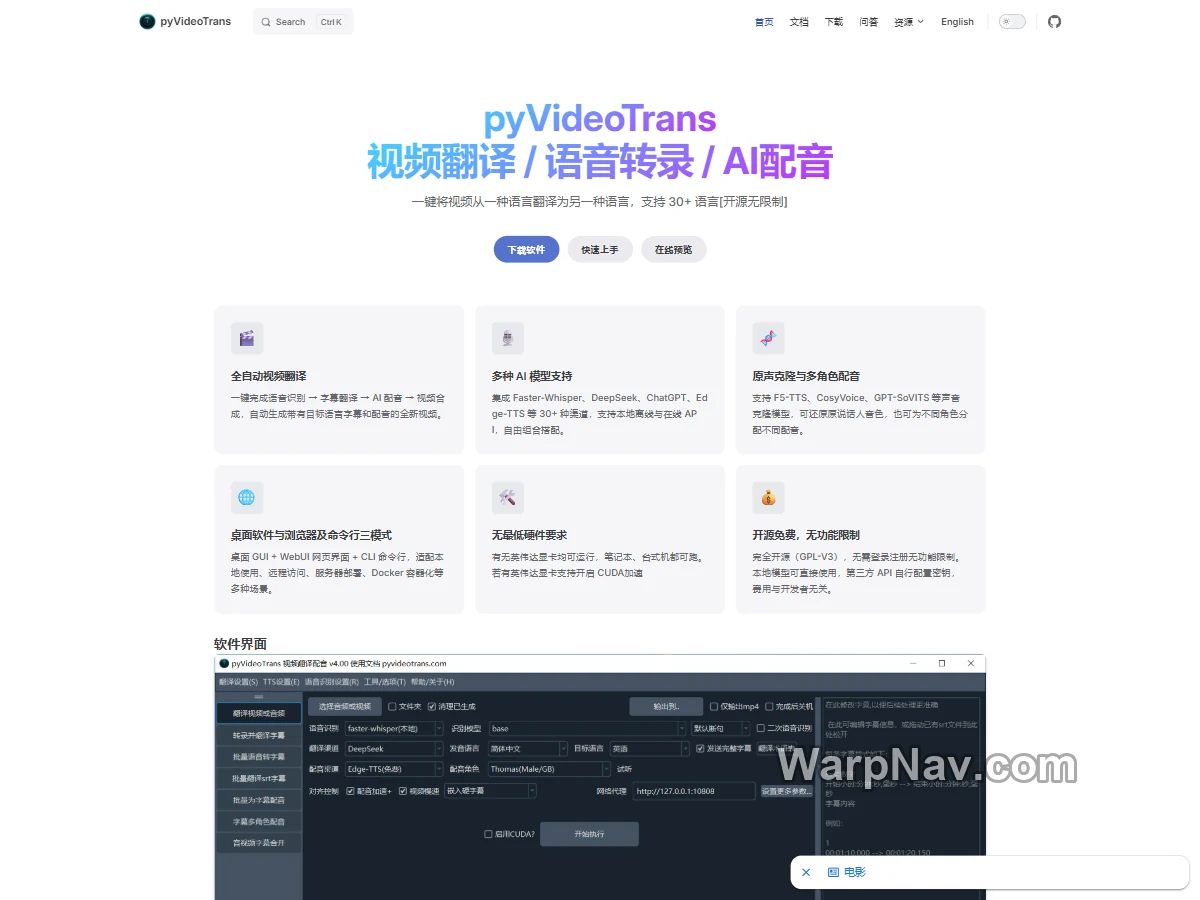
 是一个以视频翻译、语音转录、字幕处理和配音合成为核心的开源工具。它的思路不是只生成一条“黑箱成片”,而是把识别、翻译、字幕和配音拆为可选择的步骤:用户可以检查中间文本、替换术语、选择不同模型或服务,再进行最后合成。对需要处理课程、演示、开源发布说明或多语言自制内容的用户,这种可控性比一键效果更有价值。
工具可把音轨转换为时间轴字幕,先得到可编辑文本。原始识别常会错听人名、产品名和数字,所以正式翻译前应先校对源语言字幕;这一步做得越干净,后面翻译和配音的返工越少。
翻译不是逐句替换。项目开始时可以列出固定术语、品牌名和不应翻译的代码片段,再在字幕稿内统一处理。对于技术教程,保留命令、参数和界面文字的原样通常比追求口语化更重要。
配音环节可按语言、音色和节奏选择方案,再把音轨与字幕合成为新视频。不同片段的语速会影响画面同步,最好先导出 1 至 2 分钟样片,确认停顿、口型和背景音乐关系后再跑完整项目。
| 环节 | 可获得的控制 | 实际注意点 |
|---|---|---|
| 转录 | 编辑时间轴和原文字幕 | 嘈杂音频需要更多人工校正 |
| 翻译 | 指定术语与审阅译文 | 部分模型或服务需要 API |
| 配音合成 | 选择音色、语言和输出方式 | 先确认声音与素材的使用权 |
有一定技术接受度的创作者、开发者和内容团队会更容易上手,因为工具提供桌面、网页和命令行等不同入口。它采用 GPLv3 开源许可,但“开源”不等于第三方模型、翻译接口或语音服务全部免费;本地环境、显卡、网络和外部 API 的成本需要单独评估。
pyVideoTrans 适合需要可编辑、多步骤处理的本地化任务,而非追求零设置的轻量网页体验。功能支持与依赖会更新,安装、模型与 API 配置请以官方文档为准。官网: https://pyvideotrans.com/
官方说明将流程拆为语音识别、字幕翻译、AI 配音和视频合成,并提供桌面 GUI、WebUI、CLI 以及 Docker 等使用方式;软件按 GPLv3 开源,原版无需登录或卡密,但接入第三方翻译或语音 API 时,密钥和费用由使用者自行管理。
多语言项目常在发布后继续修订术语、替换配音或新增语种,所以应按项目保存原视频、音轨、字幕、术语表和配置说明。对外部 API 生成的中间结果,记录所用模型与日期,能帮助解释不同批次为何有差异。若需要多人协作,先约定字幕格式、文件命名和审核状态,再让不同成员处理不同语言;否则即使最终合成成功,也很难在后续更新时找到正确版本。上线前还要复查字幕是否与画面同步,避免翻译正确但观看体验失衡。