
Civitai
开源 AI 绘画模型权重选型与 ComfyUI 工作流实战指南。
 Replicate
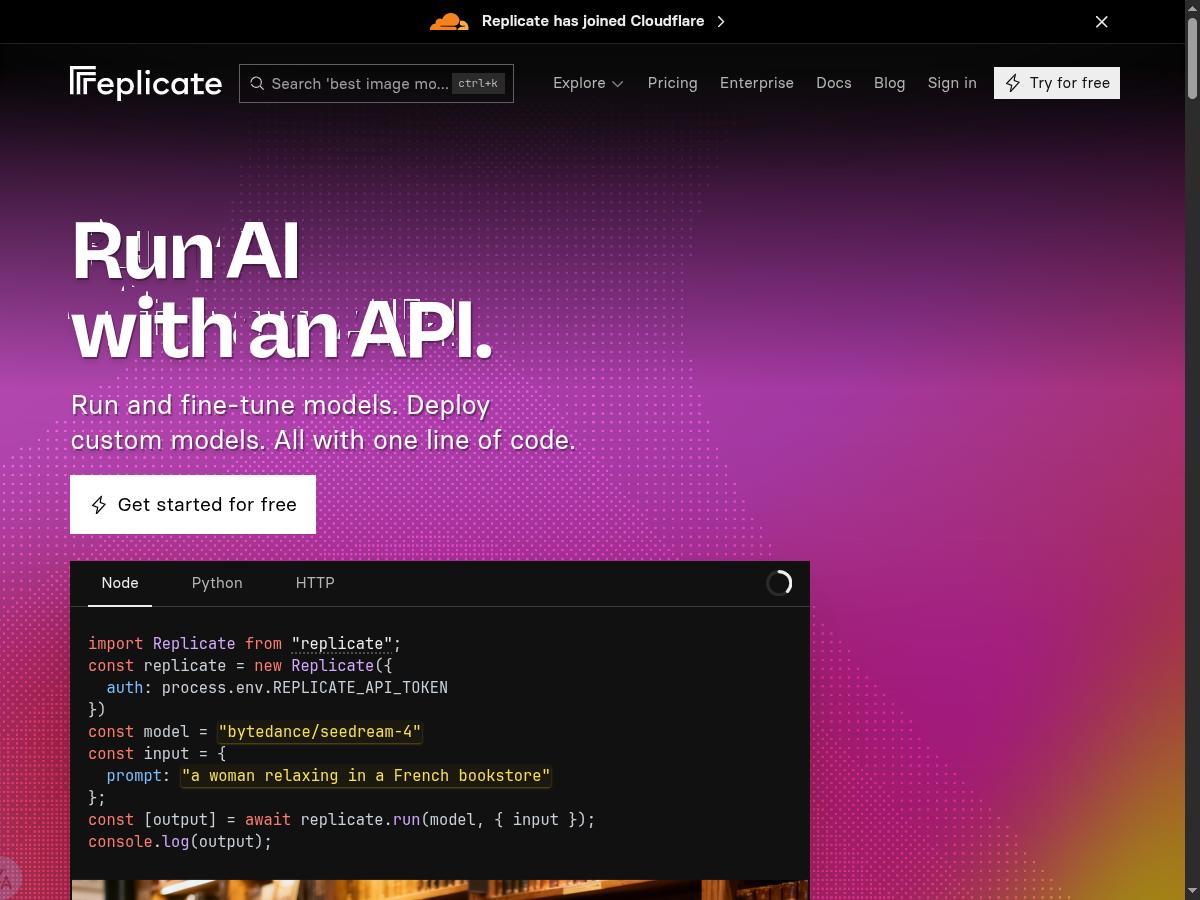
 创立于 2020 年,总部位于美国旧金山,是全球机器学习(Machine Learning)与生成式 AI 领域极具开创性的模型云端运行、API 托管与 MLOps 平台。在开源社区每天涌现成百上千款前沿模型的背后,落地却横亘着鸿沟:复杂的 Python 依赖冲突、庞大的 CUDA 驱动版本匹配难题,以及包月租赁 GPU 造成的算力浪费。Replicate 通过开源容器规范 Cog 与弹性的 Serverless 架构,成功将复杂的机器学习成果,打包成了任何开发者都能用一行代码调用的标准云端 API。
从大语言模型(Llama、Mistral)、图像扩散模型(SDXL、FLUX)到前沿语音视频模型,Replicate 托管了数万款开箱即用的开源模型。深入拆解其按秒计费的 Serverless 底层运行逻辑、精通利用 Cog 规范打包自有私有模型的实操管线,并掌握 Python SDK 异步调用实务,是现代 AI 全栈开发者不可或缺的关键基石。
传统自建模型推理集群需要承担高昂的固定闲置成本,而 Replicate 带来了创新的云计算经济学范式:
在 Replicate 的体系中,开发者无需购买、配置或手动维护底层的 GPU 服务器。平台基于事件驱动的 Serverless 架构:当发起一次 API 推理请求时,平台根据模型资源声明动态唤醒 GPU 工作节点执行计算;当前请求处理完毕且在空闲窗口期内没有新任务,计算节点便会自动释放。更为重要的是,Replicate 推行按实际执行秒数精确计费规则,不同算力规格(如 Nvidia T4、A40、A100)明码标价至每秒数美分,让初创团队也能零固定资产包袱轻装上阵,弹性调用顶尖算力资源。
为了终结“在本地可以跑、在服务器上就报错”的环境噩梦,Replicate 开源了核心容器化打包工具 Cog:
Cog 是专为机器学习打造的轻量容器打包规范。开发者无需手动编写复杂 Dockerfile,仅需两个文件即可固化为标准镜像。首先是 cog.yaml 环境配置文件:
build:
  gpu: true
  cuda: "12.1"
  python_version: "3.10"
  python_packages:
    - "torch==2.1.2"
    - "transformers==4.36.0"
predict: "predict.py:Predictor"
其次是 predict.py 业务推理入口脚本,继承 BasePredictor 并实现模型加载(setup)与单次推理(predict)接口。执行 cog build 即可自动生成生产级 Docker 镜像,并能一键推送(cog push)至云端模型仓库,实现科研模型向生产级云端服务的极速跃迁。
在业务代码中调用 Replicate 平台上的公开或私有模型,过程极其简洁直观:
开发者在安装官方库 pip install replicate 并注入 API Token 之后,即可像调用本地普通函数一样运行扩散模型。以下是调用 FLUX.1 生成高清图像的标准实操示范:
import replicate

def run_flux_prediction(prompt_text: str):
    # 发起模型异步预测请求
    output = replicate.run(
        "black-forest-labs/flux-schnell",
        input={
            "prompt": prompt_text,
            "aspect_ratio": "16:9",
            "output_format": "webp"
        }
    )
    # output 包含生成的云端媒体 URL
    for item in output:
        print("Generated image URL:", item)

if __name__ == "__main__":
    run_flux_prediction("A cinematic shot of an astronaut riding a cyber horse on Mars, 8k")
针对生成视频等需要运行数十秒的长耗时任务,SDK 还支持获取 Prediction 对象并传入 webhook 回调地址,后端无须建立阻塞式长连接,保障了高并发服务的高可用解耦。
在将 Replicate 大规模应用于企业生产系统时,架构团队必须妥善处理冷启动时延与隐私安全边界:
Serverless 架构在长时间无请求后,新请求到达时需要耗费额外数秒下载权重并加载显存。对于实时响应要求严苛的业务,Replicate 允许为模型配置预热实例数(Keep-warm instances),通过锁定常驻节点规避冷启动开销。在安全合规维度,企业可将自有微调的模型发布为“Private”私有模式,享有传输加密与专属访问鉴权,确保核心算法资产绝不被外部第三方窥探,构筑起安全可信的 MLOps 运营防线。