Similarweb
比较网站流量渠道与竞品趋势的数字市场情报平台
 Screaming Frog SEO Spider
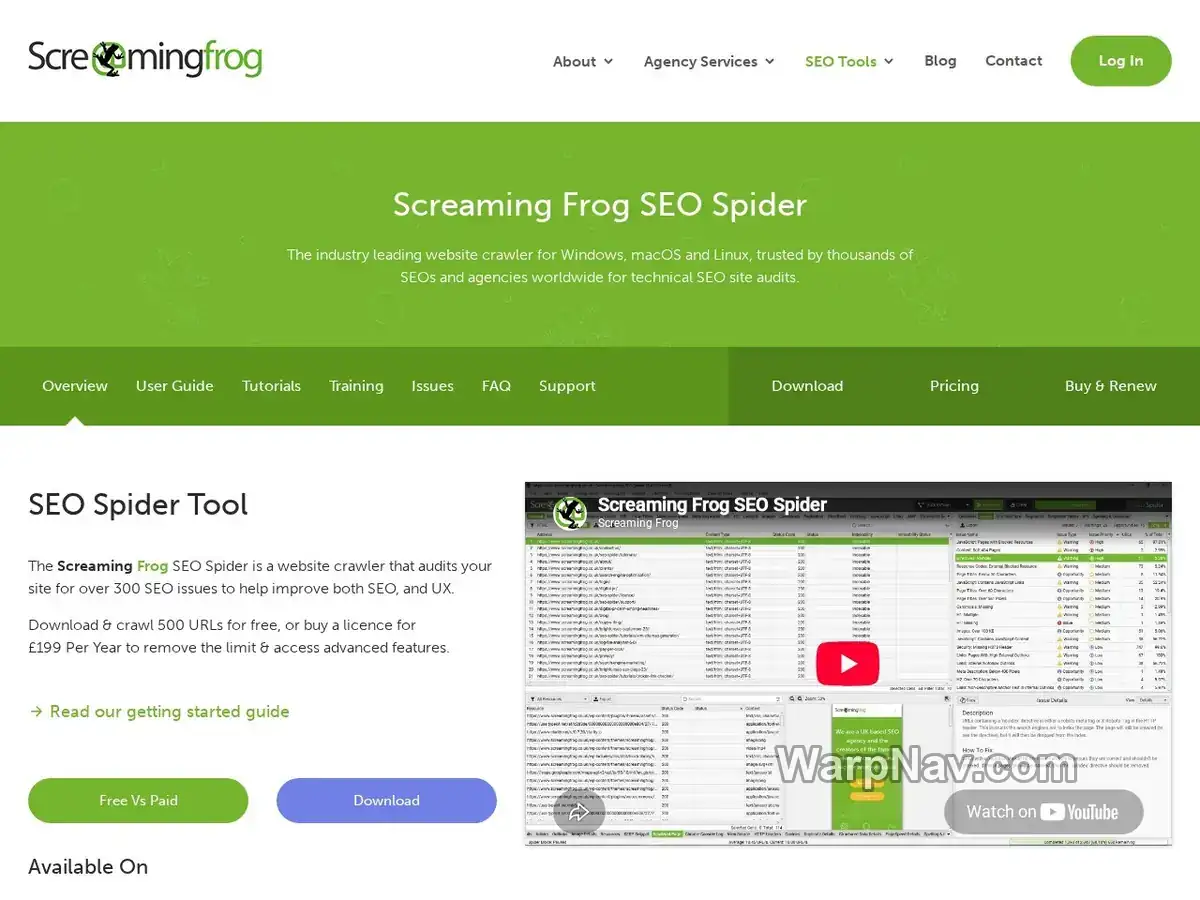
 是安装在 Windows、macOS 或 Linux 上的桌面端网站爬虫,重点是把站点的 URL、响应、页面元素、内部链接和技术问题抓出来,供 SEO、开发和内容团队复核。它不是流量统计或关键词需求数据库:爬虫告诉你页面和链接当前呈现了什么,真实访问、点击和转化仍要回到站点的一方数据核对。
| 任务 | 建议模式 | 输入与结果 |
|---|---|---|
| 从首页发现同一站点链接 | Spider | 输入起始 URL,让爬虫按链接发现页面并在各标签页实时汇总 |
| 只核对一批已知 URL | List | 粘贴或上传 TXT、CSV、XLSX、XML 等 URL 清单,避免爬到清单之外 |
| 比较改版前后或生产与预发布 | Compare | 保存两次抓取并映射 URL,查看状态码、标题、链接和问题变化 |
| 把抓取接入团队流程 | 命令行、API 或报告集成 | 按授权能力导出文件、定时运行,或接入 GA、GSC、PSI 等数据源 |
范围要先写进审计记录:是单一子域、全部子域、一个目录,还是一份 URL 清单。以根域开始时,官方说明默认可能发现并抓取子域;对大型站点或敏感环境,先用 List 或 Include/Exclude 规则缩小范围更稳妥。
例如,发现 404 只是线索;真正的动作通常是删除失效内链、补充替代页面或确认是否应设置重定向。页面标题、canonical、hreflang、结构化数据和链接深度也要结合页面意图和服务器响应判断,不能只按工具提示一键修改。
SEO Spider 默认可先抓取原始 HTML;如果内容和链接由 JavaScript 注入,再到 Configuration > Spider > Rendering 切换 JavaScript 模式,让内置 Chromium 渲染页面。渲染模式会增加资源和时间消耗,需确认脚本、图片和接口是否能在爬虫环境中正常加载,并把“源 HTML 没有、渲染后出现”的差异单独记录。
| 报告线索 | 先检查什么 | 常见后续动作 |
|---|---|---|
| 4xx/5xx、无响应 | 服务器日志、内链来源、是否为故意下线 | 修复内链、恢复页面、设置合适重定向或保留正确错误页 |
| 重定向链与循环 | 每一跳的目标、协议和规则优先级 | 合并跳转链,修复循环与错误目标,更新站内链接 |
| 重复或近似页面 | 参数、分页、模板与内容差异 | 确定 canonical、索引策略、分页关系或内容合并方案 |
| 标题、描述、H1 或结构化数据异常 | 模板变量、语言版本、实际搜索意图 | 修正模板和字段,再抽样检查不同目录和设备 |
| 内部链接与抓取深度 | 孤立页面、锚文本、目录层级和重要页面入口 | 补充上下文链接、调整信息架构,避免只追求更浅的数字 |
SEO Spider 可以生成 XML Sitemap、站点结构图和多种导出文件,也可以通过 API 接入其他指标。当前配置还可提取页面标题、描述、H1/H2、可索引性、字数、哈希值和页面大小;启用 JavaScript 渲染后可使用基于 AXE 规则的自动无障碍检查。自动检查只能形成问题线索,不能替代键盘、读屏器和真实任务测试。
导出的表格是审计材料,不是自动发布清单;涉及 canonical、noindex、重定向或删除页面时,先由页面负责人和开发确认。
官网当前说明的免费版本单次最多抓取 500 个 URL,适合小站、目录抽查和在购买前熟悉界面。授权版移除这一单次限制,并开放保存/打开抓取、更多配置、调度、JavaScript、定制提取、抓取比较以及 GA、GSC、PSI 等集成能力。授权价格、版本和系统支持会变化,购买前应以官网当前 Pricing、Download 和授权页面为准,不引用旧页面中的固定金额作为承诺。
若站点超过 500 个 URL,可以先用 List 模式抽样最重要的页面,或按目录拆分多次免费抓取;但分批结果不等同于一次完整站点审计,跨批次比较时应保留入口、过滤规则和时间窗口。需要长期监测迁移、批量导出、团队交付或大规模 JavaScript 站点时,再评估授权和机器资源是否匹配。
SEO Spider 擅长回答“页面和链接在抓取时呈现了什么”,适合技术审计、迁移验收、模板抽查和站点结构分析。关键词需求、竞品排名和市场流量需要另行使用研究工具;真实点击、索引覆盖与查询表现应使用 Google Search Console,真实访问路径和转化则可用 Matomo(原名 Piwik) 或服务器日志复核。把三类数据按同一日期和 URL 集合对齐,才能判断一个抓取问题是否真的影响用户和业务。
官网:https://www.screamingfrog.co.uk/seo-spider/