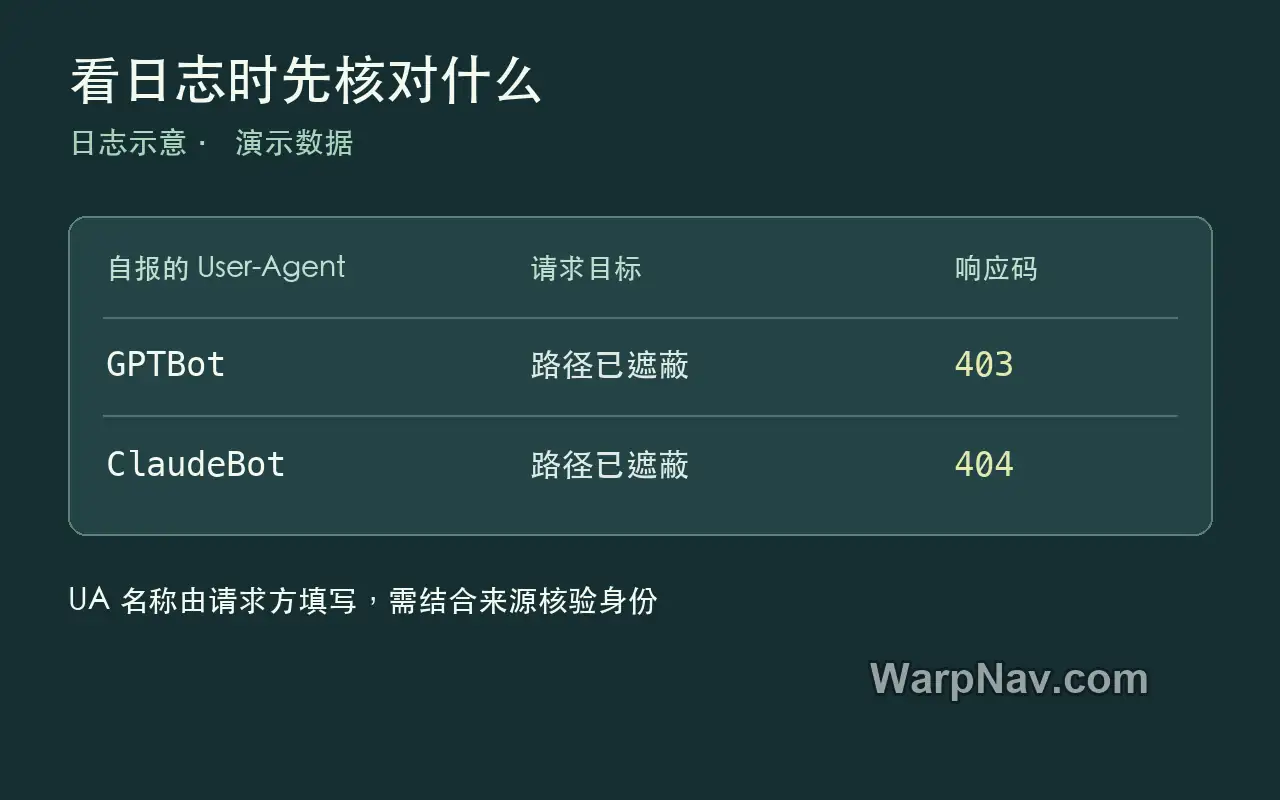
访问日志里有请求自称 GPTBot 或 ClaudeBot,却在访问站点的配置文件,先核对请求路径、响应码和真实来源地址。User-Agent 是请求方自己填的名字,出现一个熟悉的名字只能提供线索。站长最该先做的,是查 Web 根目录有没有混进私有文件,再按路径挡访问。这样即使对方改了名字,拦截也能继续生效。
怎么核对是不是官方爬虫
Tin Computer 在 11 月 18 日发布的一份报告里,把自家 10 个网站观察到的探测活动称为 Octopus、Gecko 和 Tortoise。观察期从 9 月下旬到 11 月 18 日,有些请求借用了 AI 爬虫的名字。这个样本提示站长把身份和行为分开核对:
| 看什么 | 怎么判断 |
|---|---|
| User-Agent | 先记下请求自报的名字。这个字段可由请求方填写。 |
| 来源地址 | 按厂商的验证办法核对。站点经 CDN 或反代时,从可信的代理日志、已配置的真实 IP 字段取地址。 |
| 路径、响应码和节奏 | 集中访问与站点功能无关的配置文件值得排查。结合同一时间段的请求和服务器响应,看服务是否确实返回了私有内容。 |
OpenAI 在爬虫文档里给出了 GPTBot、OAI-SearchBot 和 ChatGPT-User 各自的地址列表。Anthropic 在爬虫帮助页里提供 Claude 爬虫的来源核对入口。验证 Googlebot 可以按 Google 的文档做反向查询再正向核对,也可以对照官方 IP 列表。用 Cloudflare 时,可结合控制台的 Verified Bot 标记。
核对时尽量用各家爬虫自己的名单。一个云厂商的网段会同时服务许多客户,整段封禁会影响同网段的正常流量。
在自己的日志里看什么
报告里,部分请求的名字变化很快,另一些则集中访问同类配置文件。平时排查可以从路径入手。下面的例子只筛选本机已有的 nginx 访问日志,适用于请求行采用常见 combined 格式时。按实际情况替换日志路径。
grep -E '"(GET|HEAD) /([^ ]*/)?[.][^ ]+' /var/log/nginx/access.log | tail -n 50结合时间、站点和响应码读这几列。站点的证书签发或域名验证也可能产生这类路径,先按用途认出这些正常请求。多站点共用日志时,先定位涉及哪个虚拟主机。
检查部署是否带出了私有文件
报告说它们观测到的这 10 个站点没有返回可用的密钥。自己的站点要重点查构建输出和 Web 根目录:
- 静态站核对发布到服务器、对象存储或托管平台的实际产物。部署输出里应只有预期公开的文件,环境变量文件、版本库和编辑器的本地凭据都留在外面。
- 容器和反代检查正在运行的配置。Web 根目录应指向单独的站点输出目录,开发服务器留在开发网段。
- 客户端代码会发给浏览器。即使没有公开配置文件,也要检查构建时有没有把密钥嵌进 JavaScript 或源映射。
发布前可在自己的构建目录里只列出点开头的条目,例如 find dist -name '.*' -print。目录名按实际输出替换。宝塔、1Panel 的站点模板会随版本变化,核对的是部署生效的站点配置。
想验证现有规则,可在自己的测试环境放一个不含凭据的点文件,比较根目录和子目录的访问结果。命中规则时应返回 403 或 404,正常页面及网站正在使用的域名验证路径应能按预期响应。单页应用有时以 200 返回同一个首页,排查时要看它实际返回的页面。
按路径拦截
先把私有文件排除出站点发布目录,再在 nginx 或 CDN 上补路径规则。先确认当前站点用到哪些 /.well-known/ 路径。证书签发、域名验证等用途,沿用站点已验证的路径与目录。
在 nginx 中,可把下列正则 location 加到自己的 server 块,匹配根目录和子目录中的点文件。放在其他通用正则 location 前。用 ACME HTTP 验证时,可在同一站点保留独立的 location ^~ /.well-known/acme-challenge/,沿用已有验证目录和文件配置。使用 ^~ 的业务路由可能跳过同级正则,要在相应路由复核。
location ~ /[.] {
    return 404;
}
保存后用 nginx -t 检查,再重载并复查站点。若使用 Cloudflare 自定义规则,可以按下式匹配同类路径并设为 Block。这里以保留 ACME 证书路径为例,验证目录只放签发用的文件。站点还有其他域名验证时,为各自需要的路径保留例外。
(http.request.uri.path contains "/.") and
not starts_with(http.request.uri.path, "/.well-known/acme-challenge/")
站点规则依然需要在源站生效。使用 CDN 的站点在公开域名和自己管理的源站分别验证。站内有 Cloudflare 的网站防护入口和 nginx 配置检查与重载示例。
robots.txt 用来表达抓取偏好,配置文件的访问由服务器和 WAF 控制。OpenAI 将搜索用的 OAI-SearchBot 与训练用的 GPTBot 分开,Anthropic 也将用于搜索的 Claude-SearchBot 与 ClaudeBot 分开。按你的搜索收录和训练偏好分别设置。
如果已经漏了
- 在相应服务商作废已泄露的密钥,生成新密钥后更新部署。会话凭据泄露时,到相应服务撤销会话。
- 从发布产物、Web 根目录、对象存储移除相关文件,再清理 CDN 缓存。重新检查实际站点的响应和部署配置。
- 检查服务商的用量、账单和审计记录,排查异常调用。若文件曾进入公开 Git 历史,仍按已泄露处理。
资料来源
- Tin Computer,2026 年 11 月 18 日发布的 Octopus、Gecko、Tortoise 观察报告。
- OpenAI 爬虫及独立用途说明:https://developers.openai.com/api/docs/bots
- Anthropic 爬虫身份与验证说明:https://support.claude.com/en/articles/8896518-does-anthropic-crawl-data-from-the-web-and-how-can-site-owners-block-the-crawler
- Google Search Central 的 Googlebot 验证步骤:https://developers.google.com/search/docs/crawling-indexing/verifying-googlebot
- Cloudflare 规则语言:https://developers.cloudflare.com/ruleset-engine/rules-language/operators/
- Cloudflare 机器人管理字段:https://developers.cloudflare.com/bots/reference/bot-management-variables/
- nginx 站点 location 匹配规则:https://nginx.org/en/docs/http/ngx_http_core_module.html#location
© 版权声明
本站部分内容源于网络收集,文章等版权归原作者所有,若需删稿请联系管理员邮箱:satomini@warpnav.com
相关文章

暂无评论...
