Thinking Machines 发布 Inkling 2 Mini:26B 总参数、约 20GB,笔记本也能离线跑的开放权重编码模型
Thinking Machines 在 11 月 20 日以 Apache 2.0 协议发布了 Inkling 2 Mini 的权重:总参数 26.4B、权重占地约 20GB,却在多项长程代理编码基准上逼近体量更大的模型。它的核心看点是「循环层」(Looped Transformer)——同一组中间权重跑三遍,在不撑大显存的前提下换出更强推理,但代价也很明确:知识容量不会跟着涨。按模型卡,32GB 及以上的 Apple Silicon 设备可用于本地推理,适合在这类设备上配合搜索和工具做离线编码代理,不适合拿来当闭卷百科;官方离线演示的机器是 48GB 内存的 MacBook Pro。
Inkling 2 Mini 是什么,和 Inkling 2 Small 什么关系?
Inkling 2 Mini 是 Thinking Machines 面向端侧和单卡场景推出的开放权重多模态编码模型(支持图文输入,上下文上限 1M token),权重已同步放上 Hugging Face,并在自家 Tinker 平台提供推理与微调。
它和同家族的 Inkling 2 Small 走的是同一条架构与后训练路线:每次生成 token 都要经过 48 次层计算、每次路由选 top-8 专家,且复用了相同的监督微调数据配比和在线策略蒸馏。差别在于体量狠砍了一刀——隐藏层宽度减半(2,304 对比 4,608),每层专家数减到三分之一(128 对比 384)。官方还同步放出了一个科研版 TML-d24-varloop-research,允许在推理时自由调循环次数,方便研究深度推理与思维链可监控性。
「循环层」是什么?为什么能用更少 token 推理?
普通大模型想变聪明,常见做法是把层数叠厚或把参数堆大,结果权重文件越来越沉,笔记本根本装不下。Inkling 2 Mini 的 MoE 结构总共只有 24 个存储层(总参数 26.4B,不了解 MoE 原理可以先看这篇 MoE 混合专家模型科普),按 6 层一组拆成四块:
- 前导 6 层(第 0–5 层):跑 1 遍,负责初步消化输入。
- 核心 12 层(第 6–17 层):共享同一套权重,连续循环跑 3 遍。
- 收尾 6 层(第 18–23 层):跑 1 遍,汇总并输出结果。
算下来 6 + 3×12 + 6 = 48 层等效深度。单遍激活参数是 3.4B,多跑两遍中间层各增加约 1B,等效每 token 激活 5.4B 权重。第二、三遍循环并不是简单把输出回塞,而是通过专门学出来的门控残差,把上一轮中间层提炼的「内部消息」和初始特征融在一起继续算。
这么折腾换来两个直接收益:一是省内存,用 24 层的存储空间拿到接近 48 层的推理深度;二是省思维链长度。在官方用可变循环版做的 GPQA Diamond 测试中,都能答对的题目里,循环 3 次相比只跑 1 次,平均思维链 token 从 3703 砍掉了一半以上降到 1731,犹豫改口词(如 wait、hmm)也从 9.7 次降到 3.9 次——模型在内部多想了两圈,输出时反而少走弯路。
我的电脑能跑吗?20GB 权重背后的真实内存门槛
Inkling 2 Mini 的磁盘体积之所以能压到 20.2 GB(主权重 19.5 GB + 3 层 DSpark 投机解码草稿头 636 MB),靠的是原生混合低精度训练:前 20 层的专家权重直接按 4-bit NVFP4 训练和部署,最后 4 层用 8-bit MXFP8,非专家层保留 BF16/FP32,避开了事后硬量化掉点的老毛病。
不过「权重 20GB」不等于「24GB 内存电脑就能爽跑」,系统本身和长上下文的 KV 缓存还要占地方。结合官方硬件建议与 Hugging Face、Ollama、vLLM 首日适配文档,不同配置的实际落点如下:
| 设备内存 / 显存 | 能不能跑 | 实际体验与限制 |
|---|---|---|
| 16GB 统一内存 / 显存 | 跑不动完整原生版 | 原生权重本身就要约 20GB,系统内存不足以载入,只能等后续更低比特量化并承受明显掉点 |
| 32GB 统一内存 / 显存(Apple Silicon Mac / 其他显卡) | 官方建议起步线 | 模型卡支持 32GB 起的 Apple Silicon Mac。对其他显卡,32GB 显存是建议值,仍需核对推理框架与硬件的兼容性;NVIDIA DGX Spark 另列为支持设备 |
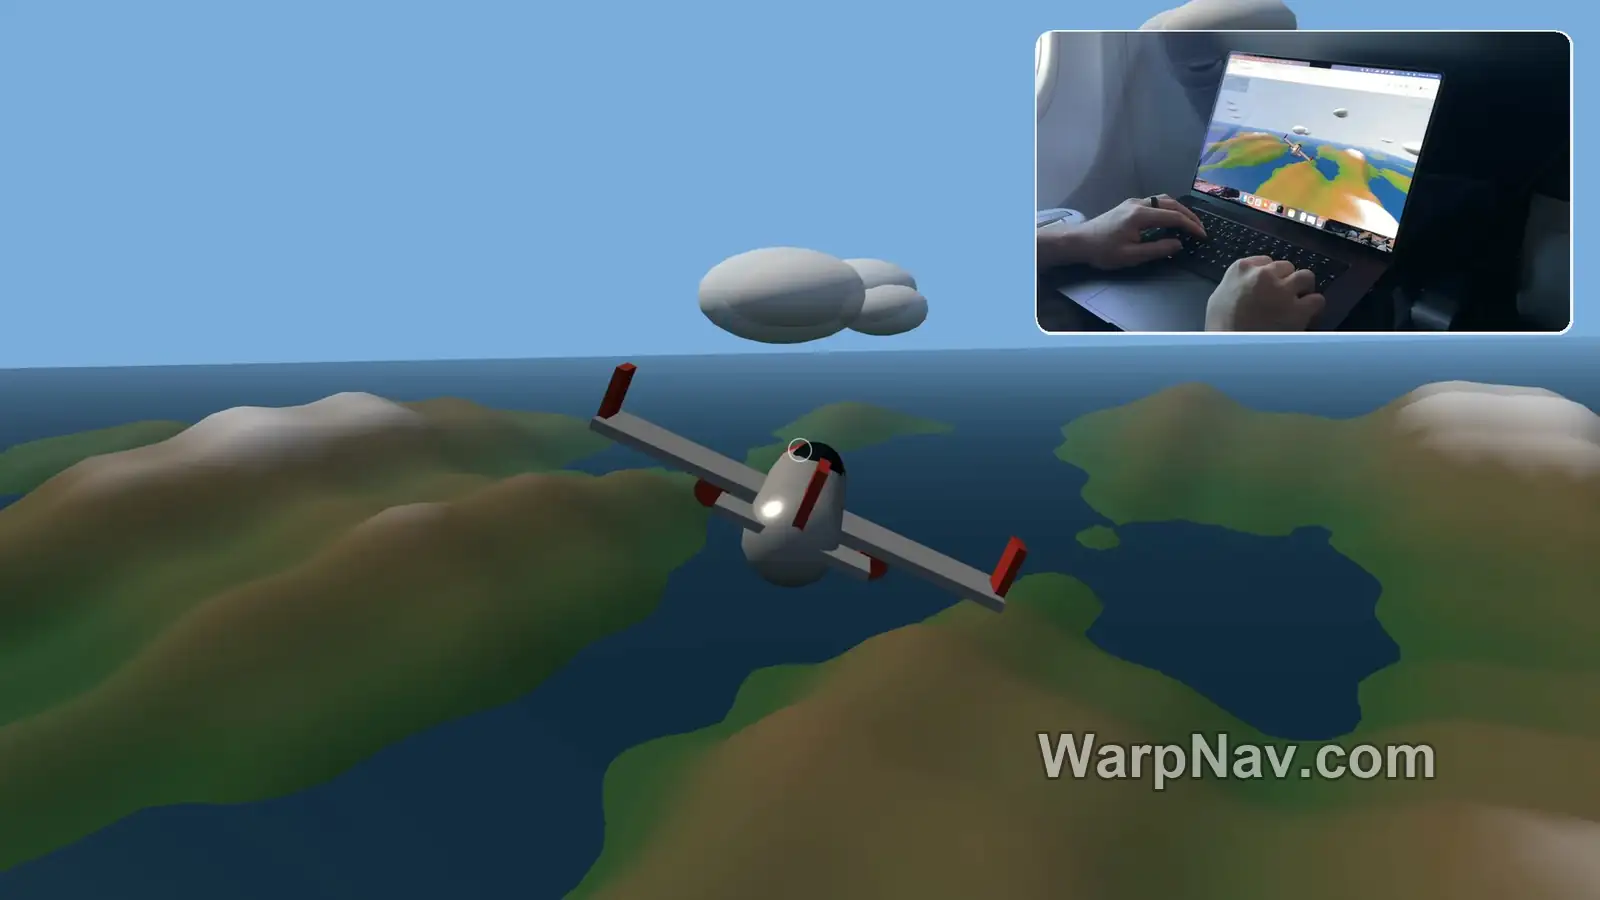
| 48GB M5 Pro MacBook Pro | 厂商已演示离线运行 | 开发团队开启飞行模式,现场生成了可玩的飞行模拟器;实际能开的上下文还取决于推理后端和可用内存 |
本地运行生态目前已经给出四条首日通道,各有前提:
- Apple Silicon 用 MLX:
mlx-lm已上游支持,最关键的是可以直接跑原版 NVFP4 + MXFP8 权重无需重新转换,保留官方原汁原味精度。 - Ollama:提供
ollama run inkling-2-mini。模型库列出了 20GB 的 MLX 版本和最高 1M token 上下文,列明支持 32GB 起的 Mac 或 DGX Spark。 - llama.cpp:
ggml-org/Inkling-2-Mini-GGUF已放出官方 4-bit(IQ4_NL)与 8-bit(Q8_0)GGUF,可用llama serve直接拉起。 - vLLM / SGLang(服务器部署):vLLM 需用
0.35.0+nightly 镜像并可开启 DSpark 投机解码;SGLang 首日适配目前要求较新 Blackwell 架构(SM103)。
如果你平时只是想搞清楚浏览器后台悄悄下载的端侧模型是怎么回事,可以对比看站内另一篇Chrome 的 Gemini Nano 端侧模型规则;Inkling 2 Mini 的 20GB 体积属于开发者主动部署的本地主力编码模型,比浏览器自带的 4GB 模型大一个档次。
和 Qwen3.8-27B、Gemma 4 31B 比,该选谁?
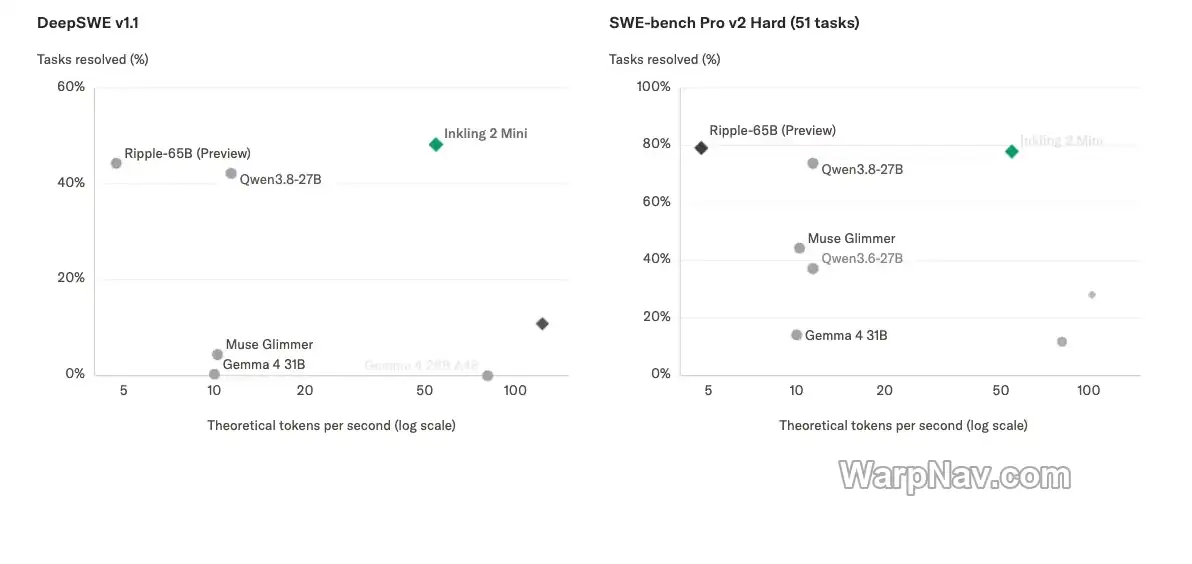
下面是 Thinking Machines 官方发布页公布的对比数据。需要特别留心:官方在图表下注明不同模型的评测框架与设置并不完全一致(例如 Terminal Bench v2.1 中 Inkling 2 Mini 使用 pi v0.83.0,SWEBench Multilingual 仅用 bash,BrowseComp 开启了上下文压缩),下表只适合看各自强弱方向,不能当成同条件横评。
| 项目 / 基准 | Inkling 2 Mini | Qwen3.8-27B | Gemma 4 31B |
|---|---|---|---|
| 激活 / 总参数 | 5.4B(循环等效)/ 26.4B | 27.0B / 27.0B(稠密) | 30.7B / 30.7B(稠密) |
| DeepSWE v1.1 | 48.2% | 42.2% | 0.3% |
| SWEBench Pro v2 (Hard,51 题) | 77.9% | 73.8% | 14.2% |
| SWEBench Verified | 79.2% | 77.8% | 46.1% |
| Terminal Bench v2.1 | 71.6% | 73.0% | 43.4% |
| Vibe Code Bench v1.1 | 77.9% | 64.9% | — |
| BrowseComp(带搜索/压缩) | 79.0% | 61.6% | 37.0% |
| AA-Omniscience v1.1 得分 / 非幻觉率 | -8.6 / 63.4% | -6.4 / 71.4% | -48.5 / 14.5% |
注:发布页上方前沿图标题里的「SWE-bench Pro v2 Hard (51 tasks)」指该评测子集共 51 道题,图中标点与表格里的 77.9% 对应同一组结果。
落到实际选型上,分工其实很清楚:
- 优先试 Inkling 2 Mini:在 32GB–48GB 的 Mac 或单卡机器上跑本地 Coding Agent、处理长仓库多文件改动、看屏幕截图写前端(ScreenSpot Pro 达 76.5% / 配 Python 87.7%)或需要长上下文检索(LongBench v2 66.9%),它靠稀疏 MoE + 循环层把单 token 访存压低,能效比优势明显。
- 继续用 Qwen3.8-27B:更看重纯终端操作(Terminal Bench v2.1 略高 1.4 个百分点)、闭卷知识非幻觉率(71.4% 对比 63.4%)或企业办公自动化类任务(AutomationBench-AA 48.2% 对比 41.8%),且机器能扛得住 27B 稠密模型的显存带宽压力。
- 看重生态成熟度或轻量端侧多模态:可以参考之前介绍的 Gemma 4 系列,不过按官方表格数据,Gemma 4 31B 在重度软件工程代理基准上并不是同赛道对手。
它不擅长什么?
官方这次把短板写得很坦诚,打算下载前先把这三条摆在桌面上:
- 循环不涨知识量:事实记忆主要跟总参数挂钩。Inkling 2 Mini 的 26.4B 总参数决定了它在闭卷知识测试(AA-Omniscience、SimpleQA Verified)上就是标准小模型水平,多循环几遍也不会凭空记住冷门史实或冷门库 API,实际用时最好给它挂上搜索、文档或 MCP 工具。
- 推理再省也不能彻底「跳过循环」:哪怕把
reasoning_effort调到最低,中间 12 层依然要跑满 3 遍,简单问答场景下首字延迟和单步计算未必比普通极小稠密模型更轻快。 - 新架构的本地工具链还在磨合:循环层 + 原生 NVFP4 刚落地,普通显卡先确认所选框架的兼容列表。以 vLLM 为例,官方配方当前要求 0.35.0 nightly 或模型专用镜像。
资料来源
- Thinking Machines 官方发布页:Inkling 2 Mini(2026-11-20,含循环架构、基准表与离线演示)
- Inkling 2 Mini Model Card(2026-11-20,含完整参数、硬件建议与安全评估)
- Hugging Face:thinkingmachines/Inkling-2-Mini(Apache 2.0 许可、20.2 GB 权重文件清单)与 Hugging Face 首日生态博客(MLX、llama.cpp、SGLang、Transformers 用法)
- Ollama:inkling-2-mini(运行命令、Mac 内存与 DGX Spark 支持)
- vLLM 官方部署配方:Inkling-2-Mini(指定 NVIDIA 硬件配置与 DSpark 投机解码参数)
© 版权声明
本站部分内容源于网络收集,文章等版权归原作者所有,若需删稿请联系管理员邮箱:satomini@warpnav.com
相关文章


暂无评论...
