最近几天,好几款「一千多亿参数」的模型被说成可以在一张显卡、甚至一台笔记本上跑。听起来像违反常识:参数更多,通常意味着权重文件更大,显存先不够。这些模型多半用了混合专家(Mixture of Experts,简称 MoE)结构——总参数可以很大,但处理每个 token 时,只叫醒其中一部分专家。token 是模型处理文字的小单位,可能是一个字、词的一部分或标点。这能降低这一步要用的计算量,却不一定能降低你必须准备的显存。下面用本周三个公开例子说明这件事,以及「笔记本就能跑」这种说法常常在哪里说满了。
先分清两个数字
看模型介绍,现在经常会并排出现两个参数量。一个是总参数(total parameters),把模型里所有可学习的权重都算进去;一个是激活参数(active parameters),表示生成每一个 token 时真正参与计算的那一部分。两者都不只统计专家:注意力、嵌入等共享部分也要计入相应的参数范围。
可以把它想成一家很大的餐厅。后厨编制了几百位厨师(专家),菜单也很厚(总参数)。你点的每一道菜,后厨只会叫来其中几位(激活参数),并不是全员围着一口锅炒。于是「看起来是 1450 亿参数的模型」在算力账单上,可能更接近一个一百亿出头的密集模型。类比到此为止:编制还在花名册上,那几百位没被叫到的厨师,他们的工具和工位如果也要塞进同一间小小的厨房(显存),厨房照样会挤爆。所以 MoE 省的是「这一步算多少」,不是自动省掉「模型得占多少内存」。
密集(dense)模型没有这层分拣:每个参数几乎都会参与每一步计算,总参数和激活参数大致是一回事。近年不少开放权重模型改走 MoE,为的就是在总容量做大的同时,把每步计算压到更可接受的范围。站内写 DeepSeek-V4 和 Gemma 4 时已经碰到过类似结构,只是当时没有把这个机制单独讲清楚。
路由是怎么把活分出去的
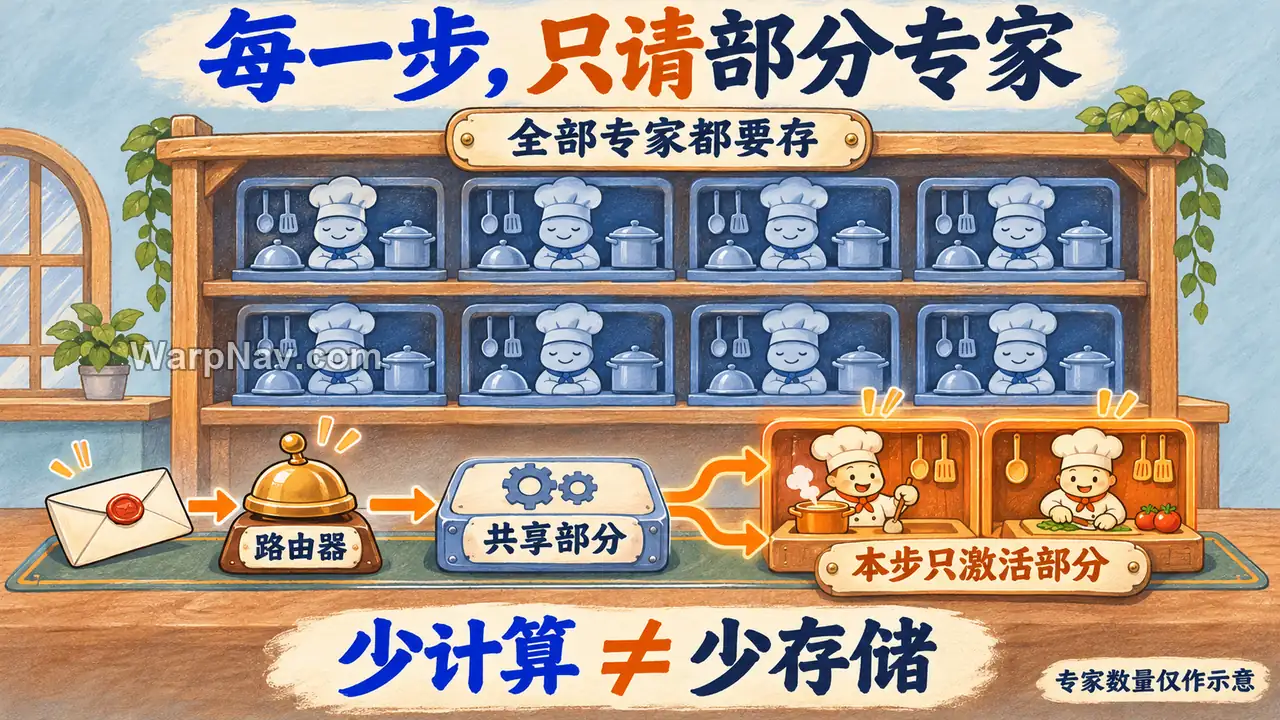
MoE 层里除了那些「专家」,还有一个路由器(router)。输入进来的每个 token,路由器会打分,再选出得分最高的几位专家来处理它。被选中的专家数量常常写作 top-k。例如 Inkling 2 Small 的模型卡写的是:每个 token 路由到 384 位专家中的 8 位;Edge0-145B 的官方模型文档则是每层 512 位路由专家,每次激活 10 位,外加 1 位共享专家。共享专家是「几乎每次都会上场」的那一位,用来承接共性计算,其余专家更分工。
不同模型的层数、专家宽度、是否先把输入压到更窄的潜空间再计算,都会影响体积和速度,这些是实现细节。对使用者,只要先抓住两件事:第一,下一步算多少,主要由激活参数和上下文长度决定;第二,模型文件有多大、启动时要占多少显存和内存,还要看未被激活的专家权重放在哪里、用什么精度存放,以及对话历史形成的 KV 缓存有多长。
为什么显存往往还是大头
即便每步只算一小部分专家,下面这几笔开销仍然在:
- 权重本身。如果所有专家都常驻显存,总参数该占多少,几乎还是要占多少,MoE 在这里帮不上忙。只有当引擎把暂时用不到的专家放在内存或磁盘上、用到再换入,总参数远大于显存才变得可行。换入换出会换来等待和总线占用,速度就会掉下来。
- 量化。同样一套权重,用 NVFP4、Q3_K 这类低精度格式存放,文件会小很多,也可能更勉强地塞进一张消费级显卡。代价是质量与速度都要另外看,不能把某种量化格式的测试结果,直接说成原精度模型的结果。
- KV 缓存。对话和长提示会把中间状态留下。上下文越长,这块涨得越明显,有时比权重还先把显存吃满。这也是为什么「模型能启动」和「能舒适地聊很长」不是同一件事。关于 GPU 和 CPU 在推理里各干什么,站内有一篇 更基础的说明。
2026 年 11 月 13 日发布的 llama.cpp v1.0.0 为卸载到主机内存的 MoE 专家增加了 GPU 缓存:常用专家留在显存里,未命中的可以按比例改由 CPU 计算,而不让 GPU 空等。命令行里是 --moe-cache-mib 和 --moe-cache-cpu-share。它解决的正是「专家放内存、常用的再送回显卡」这一层,并不能把任意千亿模型变成手机应用。
本地跑这些模型,许多人会用 Ollama 或直接用 llama.cpp,权重则常见于 Hugging Face。工具只能调用权重,改变不了模型自己的硬件门槛。
用本周三个模型对照一下
数字均来自各项目在 2026 年 11 月 14 日仍可核对的官方说明,不是本文实测。
| 模型 | 总参数 / 激活参数 | 官方给出的运行条件 | 权重情况(核验当日) |
|---|---|---|---|
| Edge0-145B | 1450 亿 / 每 token 激活 101.2 亿 | 官方模型文档:Linux 或 Windows,NVIDIA GPU,CUDA 13。文档中有一项「16 GiB 显存 + 20 GiB 内存」的 Q3_K 速度数据,但那是把 RTX 5090 D 用 cgroup 限制之后的测试预算,不是另一张卡,也不是最低配置声明。 | 推理框架仓库为 Apache-2.0;Hugging Face 上的权重许可是 edge0-community-model-1.0,不是通用开源许可。 |
| Inkling 2 Small | 5940 亿 / 170 亿 | 主推的 NVFP4 权重需要合计至少 500GB 显存,例如 2 张 B300 或 4 张 H200;备选 MXFP8 权重需要至少 800GB 显存。 | 2026 年 11 月 5 日宣布,11 月 12 日在 Hugging Face 开放权重,许可为 Apache 2.0。 |
| ERNIE 5.5 Flash | 2800 亿 / 140 亿 | 官方介绍了结构和 1M 上下文,但截至核验当日,未见面向个人显卡的官方显存门槛。不能据此写成「一张卡就能跑」。 | Base 权重已于 11 月 5 日发布;11 月 11 日的 Preview 是后训练中间检查点,API 在千帆上线,官方说后训练权重将以 Apache 2.0 开源。截至本文核验时,Preview 后训练权重仍不能与已发布的 Base 权重混为一谈。 |
三款都是 MoE,却不是同一类使用对象。Inkling 2 Small 激活参数只有 170 亿,总参数却有 5940 亿,官方硬件门槛清楚写着数百 GB 显存——这是给多卡集群准备的开放权重,不是消费级单卡模型。ERNIE 5.5 Flash 同样把激活参数压到 140 亿,现阶段更适合把它理解成「计算更省的大模型」,在看到官方给出的推理配置之前,不要脑补成笔记本方案。真正把「一张卡」写进文档的,是 Edge0-145B,而且要用它自己的推理栈来读那份文档,不能只看博客标题。
「笔记本就能跑」差在哪
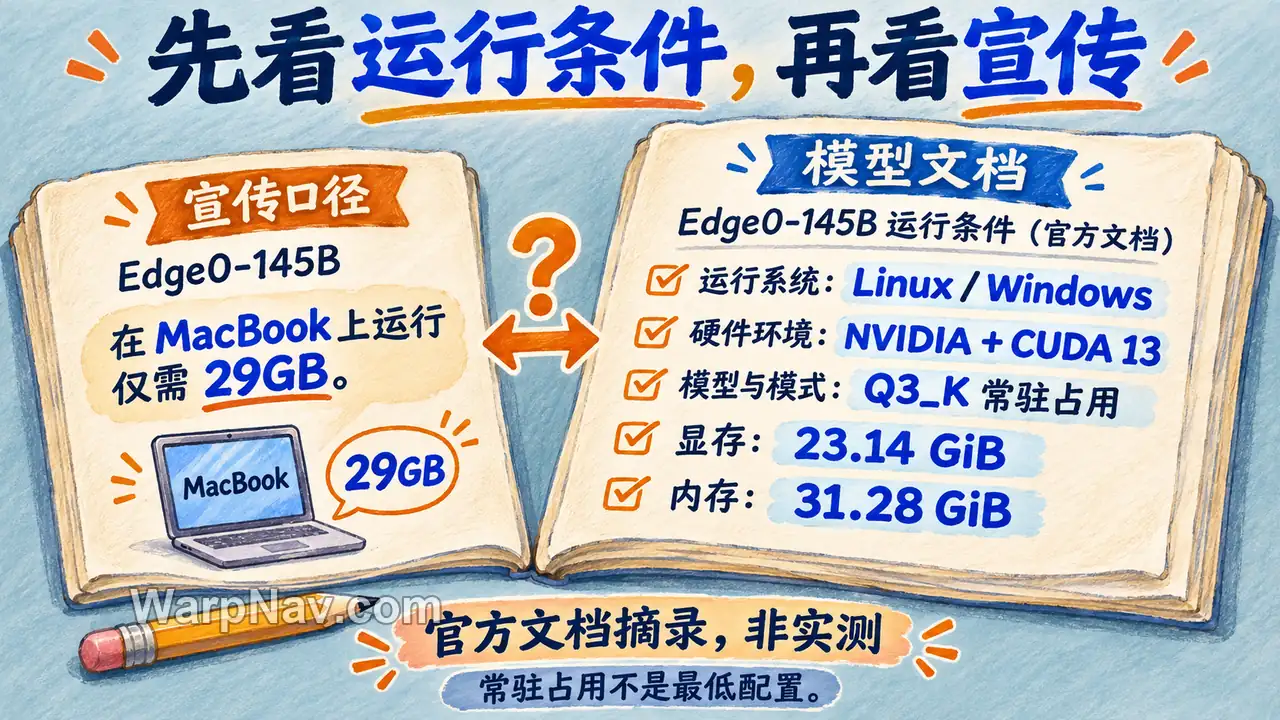
Edge0 的博客标题和开篇把 Edge0-145B 写成可在个人电脑、包括 MacBook Pro 上运行的 1450 亿参数模型,并给出峰值内存 29GB、解码超过每秒 80 个 token 等数字;页末 FAQ 还写到支持 macOS、Windows、Linux,以及 Apple M 系列和 NVIDIA RTX。GitHub 仓库简介也同样写着「145B on a laptop」以及 Mac、iPhone 等平台。
同一项目的模型文档口径不同。在 docs/models/edge0-145b.md 里,运行要求明确是「Linux 或 Windows,配备 NVIDIA GPU 和 CUDA 13」。文档保留了 Apple M2 Ultra(Metal)的速度数据,但紧接着写:这些结果并不构成 macOS 已发布可用的依据。也就是说,有人在 M2 Ultra 上做过测量,和「你现在可以在 MacBook 上下载并官方支持地运行」不是一件事。
那项常被转发的「16 GiB 显存 + 20 GiB 内存可跑 Q3_K」,也需要看原表注脚。官方写明:这是同一张 RTX 5090 D 24GB,用 cgroup 把显存和内存预算限制到 16 GiB + 20 GiB 之后测出的速度,不是另买一张 16GB 卡、更不是某台轻薄本的配置。同一页还给出了「常驻打开」时的占用:145B 的 Q3_K 权重本身是 40.81 GiB,常驻时约为 23.14 GiB 显存加 31.28 GiB 内存;NVFP4 权重 47.79 GiB,常驻时约为 23.25 GiB 显存加 38.27 GiB 内存。这已经明显高于 16+20 的测试预算,说明那行速度数字对应的是专家未全部常驻、需要换入换出的跑法。预算测试能跑通,不等于这就是推荐配置,也不等于换到其它 16GB 显卡就能得到相近速度。
博客里的 29GB 峰值内存、80+ tokens/s,以及「兼容的笔记本,例如 MacBook Pro」,与上述平台要求和常驻占用对不上。在官方把博客、FAQ 和模型文档改成一致之前,更稳妥的读法是:以模型文档的平台表和注脚为准,把 29GB、MacBook 表述看成营销页面上尚未自洽的说法,而不是已经核实的最低配置。Edge0-120B 在同一文档里有自己的体积和速度表,原则相同,这里不展开。
Inkling 2 Small 则几乎不会产生这种误会:开放权重是事实,硬件门槛也写得很直白。5940 亿总参数、170 亿激活,并不能让它跑进笔记本,因为它默认要把权重放在合计至少 500GB 的显存里。MoE 在这里体现的是「每步算得少」,不是「机器可以很小」。
激活参数也不是显存账单的全部
即便只看「能在一张 NVIDIA 卡上跑」的 Edge0-145B,官方架构表也提醒:1450 亿这个总数里,不全是每步都会算到的专家。它的专家池约为 846 亿参数,另外还有一张约 512 亿参数、以 fp8 存放、按内存映射方式加载的逐层 n-gram 嵌入表(文档里称作 PLE),以及约 12.6 亿参数的推测解码头。上下文标称 256K,KV 使用 int8,其中 32K 常驻。也就是说,启动之后占多少内存,还要算进这张大表怎么映射、上下文开到多长,而不能只用「激活 101.2 亿」反推。
这并不否定 MoE 的作用——每步仍然只跑 10 位路由专家加 1 位共享专家——而是说明宣传里给出的单个数字,很少能对应到你机器上的那一行占用。读官方文档时,优先看平台、精度、常驻还是换入、以及这些附属表的加载方式,会比只比较总参数更接近实际情况。
以后再看到类似宣传,可以先问这三句
- 这两个数字分别是总参数还是激活参数?只有总参数、不谈激活,说明不了每步要算多少;只有激活、不谈权重放在哪,说明不了你的显卡能不能放下。
- 官方有没有写清平台、精度和是否需要多卡?把「cgroup 限制后的测试预算」读成「最低配置」,或把某一代旗舰卡上的结果说成「普通笔记本」,都属于跨过了原文注脚。
- 许可和推理栈是不是一回事?框架开源、权重却是社区许可,或权重开源却只要集群显存,都会改变你能不能用、在哪用。
MoE 仍然是现在把模型做大、又想控制每步计算的常用方法。它解释得了「为什么 1450 亿参数不一定等于 1450 亿参数的密集模型那样去算」,解释不了「所以它一定能在你的笔记本上跑」。能跑到什么硬件上,要看权重放哪里、用什么精度、官方承认哪些平台——以及这些说法之间是否互相打架。
资料来源
- Edge0 模型文档(平台、精度、速度表注脚与常驻占用):Edge0 145B / 120B 官方模型文档
- Edge0 发布博文(宣传口径对照):https://edge0.ai/blog/introducing-edge0-145b-frontier-ai-capabilities-on-your-own-computer
- Inkling 2 Small 模型卡(参数、专家数量与硬件要求):https://huggingface.co/thinkingmachines/Inkling-2-Small
- Thinking Machines 发布与开放权重更新:https://thinkingmachines.ai/news/inkling-2-small/
- ERNIE 5.5 Flash Base 架构说明:https://ernie.baidu.com/release/ernie-5-5-flash-base/
- ERNIE 5.5 Flash Preview 发布与后训练状态:https://ernie.baidu.com/release/ernie-5-5-flash-preview/
资料核对日期:2026 年 11 月 14 日。参数和运行条件来自对应模型文档,未将厂商演示或测量表当作本文实测。
© 版权声明
本站部分内容源于网络收集,文章等版权归原作者所有,若需删稿请联系管理员邮箱:satomini@warpnav.com
相关文章

暂无评论...
