Jina Reader API
将公开网页转成 Markdown 或 JSON
 FireCrawl
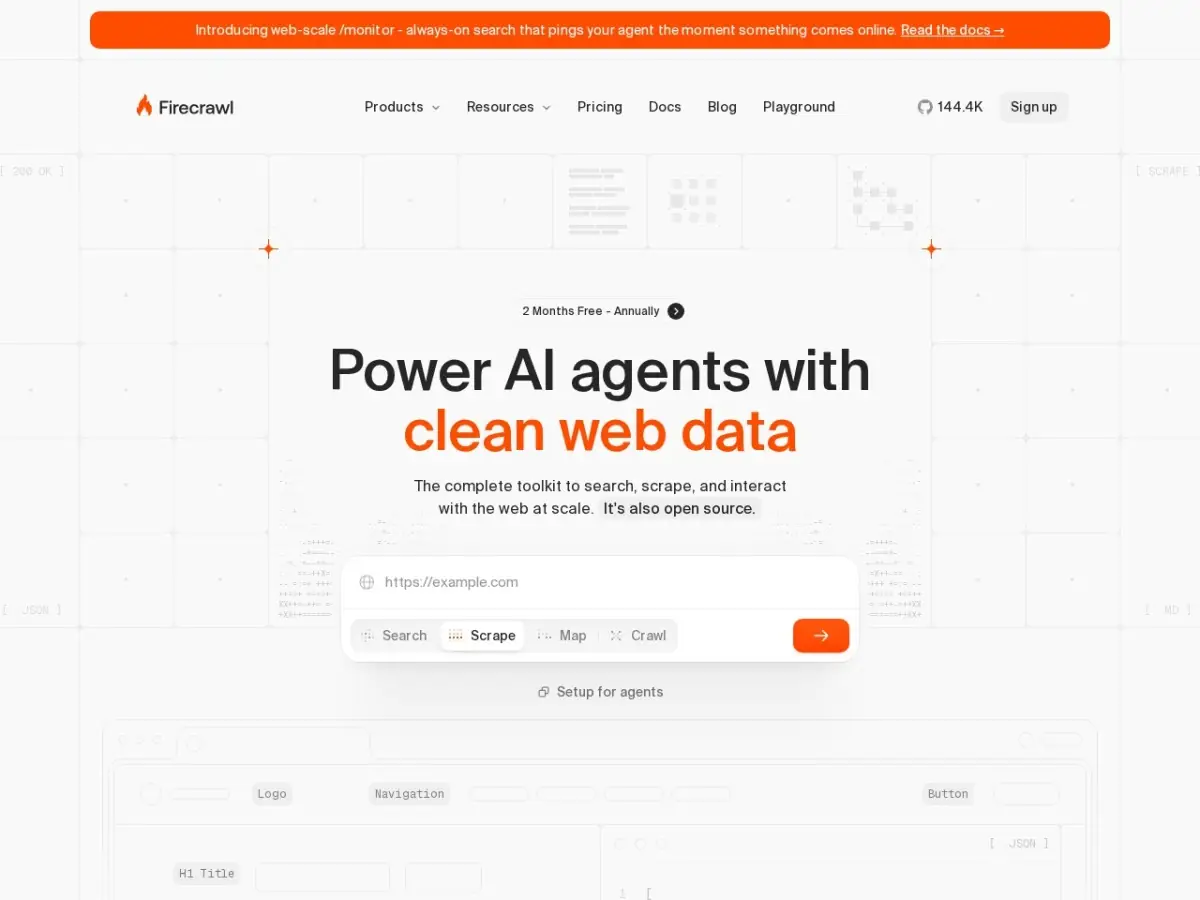
Firecrawl v2 是托管网页数据 API,代理、浏览器渲染、缓存和部分反爬处理由服务端承担。接入时最容易犯的错误,是把 Scrape、Map、Crawl 当成“抓取深度不同的同一个按钮”。它们返回的对象、计费方式和失败含义都不同,端点选错会在内容尚未证明可用前就放大范围。
| 当前已知信息 | 应该调用 | 主要结果 |
|---|---|---|
| 已有一个公开 URL,需要正文 | POST /v2/scrape |
markdown、html、links、screenshot 或结构化格式及 metadata |
| 只有站点入口,需要找到相关 URL | POST /v2/map |
以 links 为主的站内地址清单 |
| 种子、范围、输出格式已确定 | Crawl | 异步 job,按发现页面陆续生成内容 |
例如要把 Firecrawl 官方文档接进 RAG,先对文档首页调 Scrape 检查 Markdown;需要“billing”相关文档地址时,再 Map 并设置 search;只有这些页面的输出格式达标,才值得用小 limit 的 Crawl 批量获取。
Python SDK 当前示例允许无 Key 起步,需要更高限制时再加 Key:
doc = firecrawl.scrape("https://docs.firecrawl.dev", formats=["markdown"])
formats 默认是 markdown,也可请求 html、links、screenshot、JSON、question、highlights 等。标题与正文对得上原页,只能说明内容层通过;还应查看 metadata.statusCode。官方计费说明指出,即使目标站返回 403 或 404,基础设施已经处理请求,仍可能扣 credit,因此不能只对 API 自身的 200 响应做判断。
Map 主要依赖 sitemap,并结合搜索结果和历史抓取数据提高覆盖率。search 可按主题排序,sitemap 可设 include、skip、only,limit 控制返回数量;位置参数还能影响国家、语言和时区。它优先速度,不保证穷尽站点。
截至 2026-09-16,官方说明每次 Map 请求固定 1 credit,与返回 100 条还是更多 URL 无关。得到 links 后要抽查域名、路径和相关性;如果只需从清单挑 20 个页面,直接对这些 URL Batch Scrape,通常比把整个站交给 Crawl 更可控。
POST /v2/crawl 创建异步任务并返回 job ID,之后用 GET /v2/crawl/{jobId} 轮询。结果含 status、total、completed、creditsUsed 和 data;数据超过 10 MB 时还要继续读取 next。官方说明完成后的 API 结果保留 24 小时,因此应及时持久化,而不能把返回地址当长期文件库。
页面处理完成后逐步计费,轮询状态本身不扣 credit。需要特别注意:官方 billing 页写明默认 limit 为 10000;任务开始前会检查余额是否足以覆盖请求的 limit。即使站点最终只有几十页,省略 limit 也可能因为余额不足直接返回 402。首次任务应明确写一个与目标范围一致的小 limit,并把路径、子域、查询参数与 formats 固定在同一配置里。status=completed 只表示任务结束,不证明发现了整站所有页面。
当前基础 Scrape/Crawl 为每页 1 credit;JSON 格式额外 +4,Enhanced Mode 额外 +4,两者同时使用就是每页 9 credits。question、highlights、PII redaction、音视频提取等也有附加成本。Map 固定按请求计费,不应与 Crawl 的每页计费混算。余额耗尽且未开 Smart Upgrade 时,请求返回 402;429 则属于速率或并发限制。最新数字应回到官方 Billing 文档核对。
正文是登录墙或空页,回到 Scrape 的等待、动作、代理和格式;Map 返回大量无关链接,修改 search、sitemap 与路径范围;Crawl 任务过大,降低 limit 或改成 Map 后选 URL;402/429 则查余额、预检 limit 和并发。把这几类错误都归结为“网站难抓”,只会让下一次调用继续浪费 credit。
Firecrawl 仓库采用 AGPL-3.0,当前最新 Release 与托管 API 的部署节奏也不必然同步。官方明确把 Fire-engine、代理与渲染基础设施、Interact 和分析 Dashboard 列为 Cloud 能力,不能因为有开源仓库就断言自托管版与付费服务完全等价。需要自托管时,应另行评估代理、浏览器集群、存储、升级和运维成本。