
观测云
用指标、日志和链路还原故障并控制采集成本
 Tavily
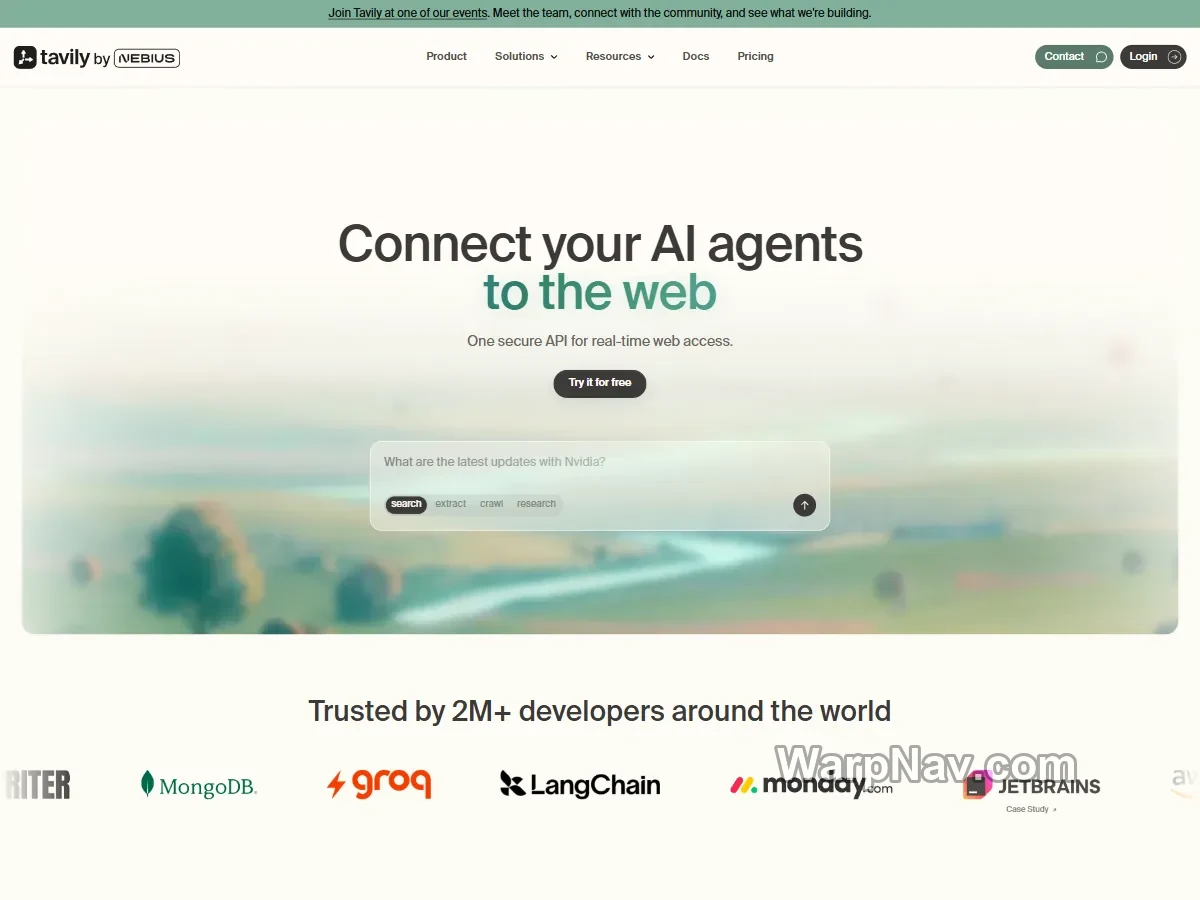
 是面向 AI Agent 与 RAG 工作流的托管式网页访问 API。它不只提供搜索结果,还把网页内容提取、站点 URL 发现、多页抓取和深度研究放在同一产品入口中。它适合希望用统一 API 获取实时网页证据、又不想自行维护搜索索引和浏览器抓取基础设施的开发者;但不同端点解决的问题并不相同,接入前应先从任务输出倒推。
| 端点 | 主要任务 | 典型输出 |
|---|---|---|
| Search | 围绕查询寻找当前网页来源 | 结果列表、摘要与来源 URL |
| Extract | 读取一组已知 URL 的正文 | 清理后的页面内容 |
| Map | 发现站点内可能相关的 URL | 可继续筛选的地址集合 |
| Crawl | 从起点沿站内链接抓取多页 | 多页正文与来源关系 |
| Research | 围绕问题组织多来源调查 | 带来源的综合结果 |
选择时不要因为产品同时拥有这些入口,就默认每次任务都要全部调用。已知单页只需要 Extract;未知来源先 Search;文档站导入才考虑 Map 与 Crawl;需要跨来源综合时再评估 Research。官方计费文档当前把 basic Search 记为每次 1 credit、advanced Search 记为每次 2 credits;Extract 则按成功提取的 URL 数量分组计费,basic 每 5 个成功 URL 为 1 credit,失败提取不计费。成本记录应同时保存端点、深度、成功 URL 数和重试,而不是只数 HTTP 请求次数。
为知识库导入文档站时,先用 Map 了解 URL 结构,再限制路径、深度和页数,最后让 Crawl 读取真正需要的页面。这样比从首页无限扩散更容易控制重复页面、语言版本、标签归档和失败重试。入库前仍要自行完成去重、分块、元数据、更新时间和来源 URL 保存,Tavily 不是向量数据库,也不会替代知识库质量验收。
Agent 需要回答当前问题时,可以先用 Search 找候选来源,再对少量高相关 URL 使用 Extract,保留原始链接供引用和复核。若任务只需要一个已知页面,直接 Extract 通常比启动整站 Crawl 更简单。网页内容仍可能包含提示注入、错误信息或过期事实,因此模型输出前需要来源过滤、内容隔离和人工可追溯记录。
Research 属于更上层的调查流程:系统围绕问题检索、读取并综合多个来源。它适合需要多来源证据的研究型任务,但不等于“把某个站点全部下载下来”。若目标是建立可重复更新的文档语料,Map/Crawl 更容易限定范围;若目标是回答一个跨站问题,Research 才可能减少上层编排工作。
Tavily 将 Search、Extract、Map、Crawl 与 Research 放在统一 API 中,但每个端点解决的问题不同。可先比较 Tavily 与其他 AI、RAG 网页数据工具,按最低必要能力选择入口,再用相同样本检查可交付结果、来源保留和失败记录。
Tavily 的价值在于把搜索与网页访问能力做成适合 Agent 调用的统一入口,而不是保证所有网站都能无条件读取。正式接入前应以官方 API 文档核对当前端点、参数、计费和数据政策。官网:https://tavily.com/;文档:https://docs.tavily.com/documentation/api-reference/introduction