PDFMathTranslate
保留公式与版式的学术 PDF 双语翻译工具
 MinerU
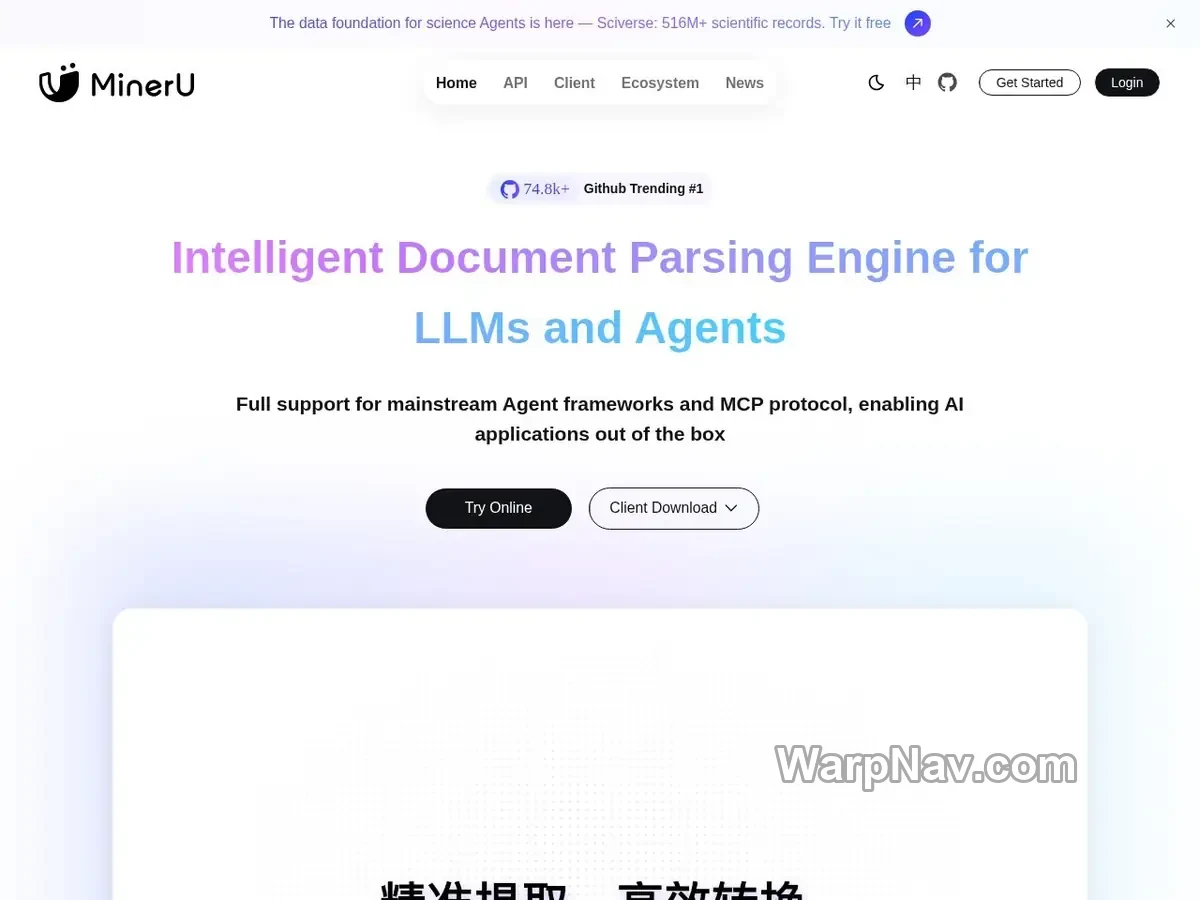
是一类把 PDF、图片和 Office 文档转为更易处理的结构化内容的工具,常见目标输出包括 Markdown 与 JSON。它适合把原本难以检索、难以引用的资料整理为可阅读、可切分、可进入知识库的文本结构:研究者可以先提取论文内容,团队可把说明文档整理为检索素材,开发者也能为 RAG 或自动化流程准备输入。它解决的是“文档理解和结构提取”,并不是把所有文件一键变成完全可靠的数据库。
在真正进入知识库前,可以抽样查看标题层级、段落顺序、表格单元格和图片说明是否被正确识别,并记录常见异常类型。对重复页眉页脚、目录、脚注和分页断句做一次清理,往往比盲目追加更多模型更能提升检索质量。若数据来自多个来源,也要保留文件名、版本号与处理时间,方便以后回溯。
解析质量必须通过真实样本验证;任何自动化流程都应为错误、漏项和不可解析文件预留人工介入的位置。
先用少量代表性文件做验收,再扩大处理范围,通常比一次性导入全部资料更稳妥。
把“解析失败”也视为可记录的结果,能帮助团队更快找到需要改进的文件类型和流程。
可靠的资料治理应从每一次导入前开始。
复杂文档包含标题层级、段落、表格、图片、公式和多栏布局。MinerU 尝试识别这些区域,再输出可继续编辑或被程序读取的结构化结果。对于清晰的数字原生 PDF,效果通常更容易检查;扫描件、手写内容和低分辨率图表则需要预留人工复核时间。
官网提供在线体验、API、客户端和开源生态相关入口。轻量任务可以先通过在线方式观察解析结果与格式;需要稳定批量处理、内部资料隔离或系统集成时,应根据官方文档选择 API、客户端或自建路径,并计算实际资源成本和维护责任。
Markdown 与 JSON 的价值在于后续可按标题切分、保留段落上下文并写入搜索或知识库系统。实际流程中仍要做去重、清洗、来源标记和权限控制;若把错误解析、过期版本或无授权资料直接导入,后续问答系统只会放大这些问题。
| 人群或任务 | 能解决什么 | 建议检查点 |
|---|---|---|
| 科研阅读 | 提取论文结构与正文 | 公式、图注与引用是否完整 |
| 知识整理 | 将资料转成可检索文本 | 版本、来源和权限标记 |
| 开发集成 | 为检索或 Agent 准备输入 | 接口额度、错误处理与日志 |
当前官方仓库采用以 Apache 2.0 为基础、带附加条件的 MinerU Open Source License;对外提供基于 MinerU 的在线服务需按许可履行显著标识,达到协议规定规模阈值还需另行核对商业许可。部署前应直接阅读当前 LICENSE,而不是沿用旧文章对许可证的概括。
若你需要先把文档变成可被人和程序共同利用的结构化内容,MinerU 是中文生态中值得关注的入口。官网:https://mineru.net/