PDF 转 Word 后乱码、空白或排版全乱怎么办?原因判断与修复顺序 PDF 转 Word 后乱码、空白或排版全乱怎么办?本文通过文字层、复制结果和复杂版式完成快速诊断,并给出 OCR、换转换引擎、局部提取、手工重排及转换后验收步骤。 曲速指南# OCR# PDF 2026-07-292,001
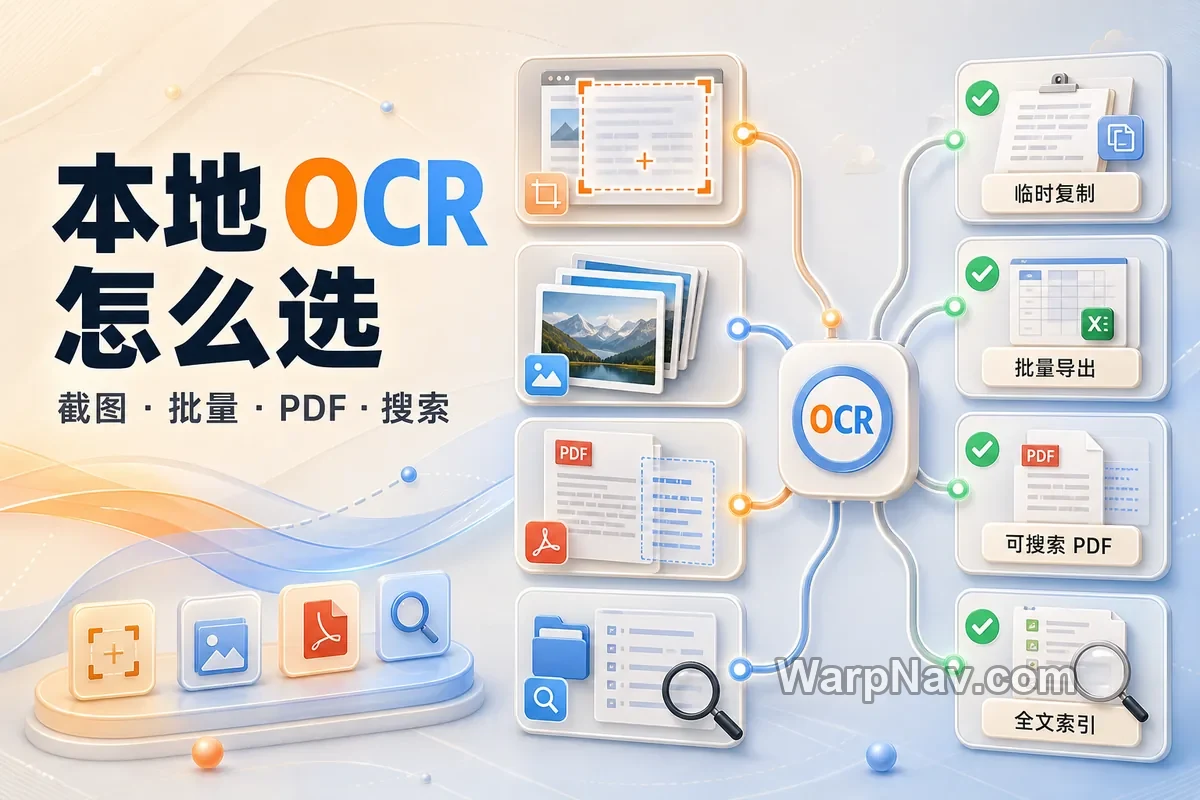
Windows 本地图片转文字工具怎么选?截图、批量 OCR、PDF 与全文搜索的区别 Windows 图片转文字工具怎么选?本文按临时截图复制、批量图片导出、扫描 PDF 文字层和存量文件全文搜索四种任务,比较系统截图工具、PowerToys、PixPin、Umi-OCR、NAPS2 ... 曲速指南# OCR# PDF# Windows 2026-08-301,576
扫描版 PDF 怎么变成可搜索、可复制的文件?OCR 判断、处理与验收指南 扫描版 PDF 不能搜索或复制?本文教你判断文字层,选择本地或在线 OCR,区分可搜索 PDF、Word 与结构化提取,并用完整清单验收识别结果。 曲速指南# OCR# PDF 2026-08-101,650
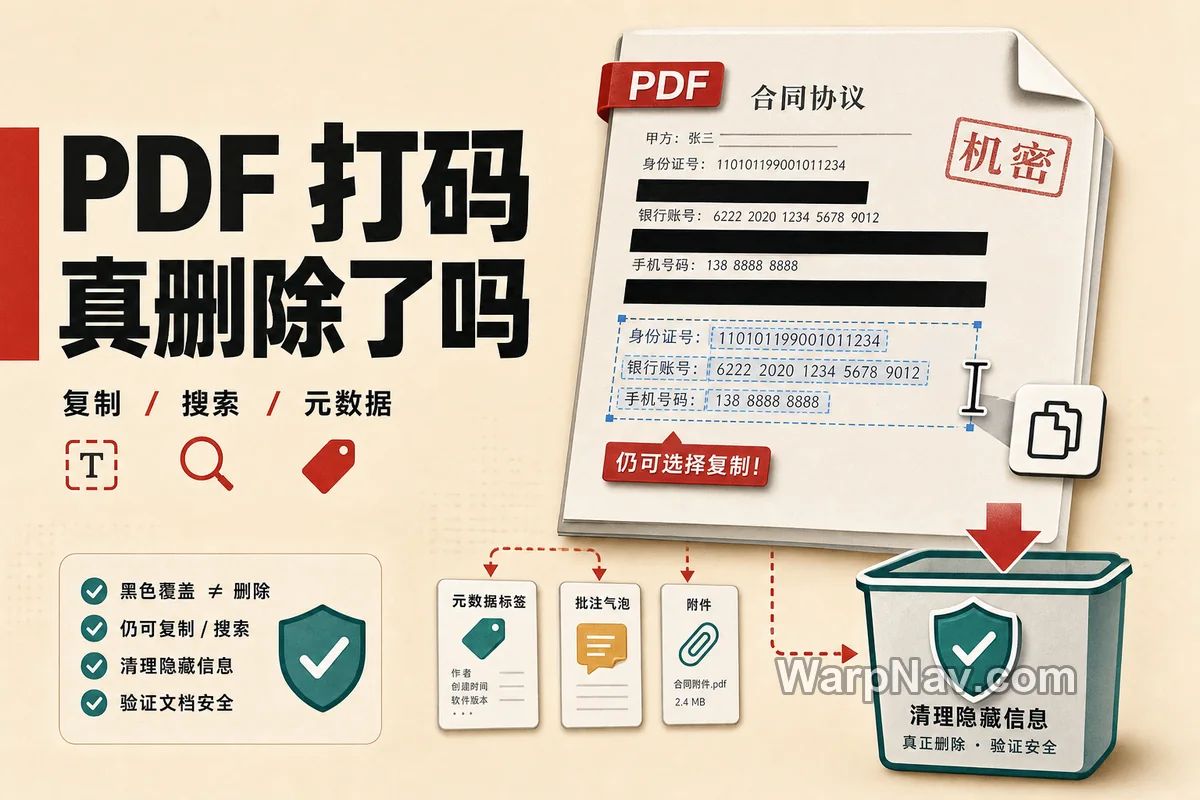
PDF 打码为什么还能复制:真正删除敏感文字与隐藏信息的方法 PDF 打黑框后为什么还能复制?本文区分视觉遮挡、真正密文处理、隐藏信息清理与加密,说明文字型 PDF、扫描件和 OCR 文件的安全处理顺序与导出验收方法。 曲速指南# PDF# 隐私安全 2026-07-261,642
[Github] PDFCraft – 浏览器本地处理的开源 PDF 工具箱 PDFCraft 是浏览器本地处理的开源 PDF 工具箱,覆盖合并、拆分、转换、编辑、安全与工作流编排,并提供桌面安装包和自托管方案。本文介绍其功能、隐私边界、部署限制与适用人群。 Github发现# Github项目# PDF# 开源项目 2026-08-301,340
[Github] OpenDataLoader PDF – AI 开源 PDF 解析转写工具 OpenDataLoader PDF 面向 AI 数据抽取、RAG 知识库和 PDF 无障碍处理,支持多语言调用、布局分析、OCR、结构化输出与 Tagged PDF;本文整理部署、批处理和 Hybr... Github发现# Github项目# PDF# 开源项目 2026-08-301,517
[Github] PDFMathTranslate – 保留公式与排版的 PDF 双语翻译工具 PDFMathTranslate(pdf2zh)面向学术和技术 PDF 双语翻译,尽量保留公式、图表与布局,支持多翻译后端、CLI、GUI 和 Docker;本文说明效果与版权边界。 Github发现# Github项目# PDF# 开源项目 2026-08-301,949