
Google Dataset Search
跨数据仓库检索公开数据集的专用搜索引擎
 OpenDataLab
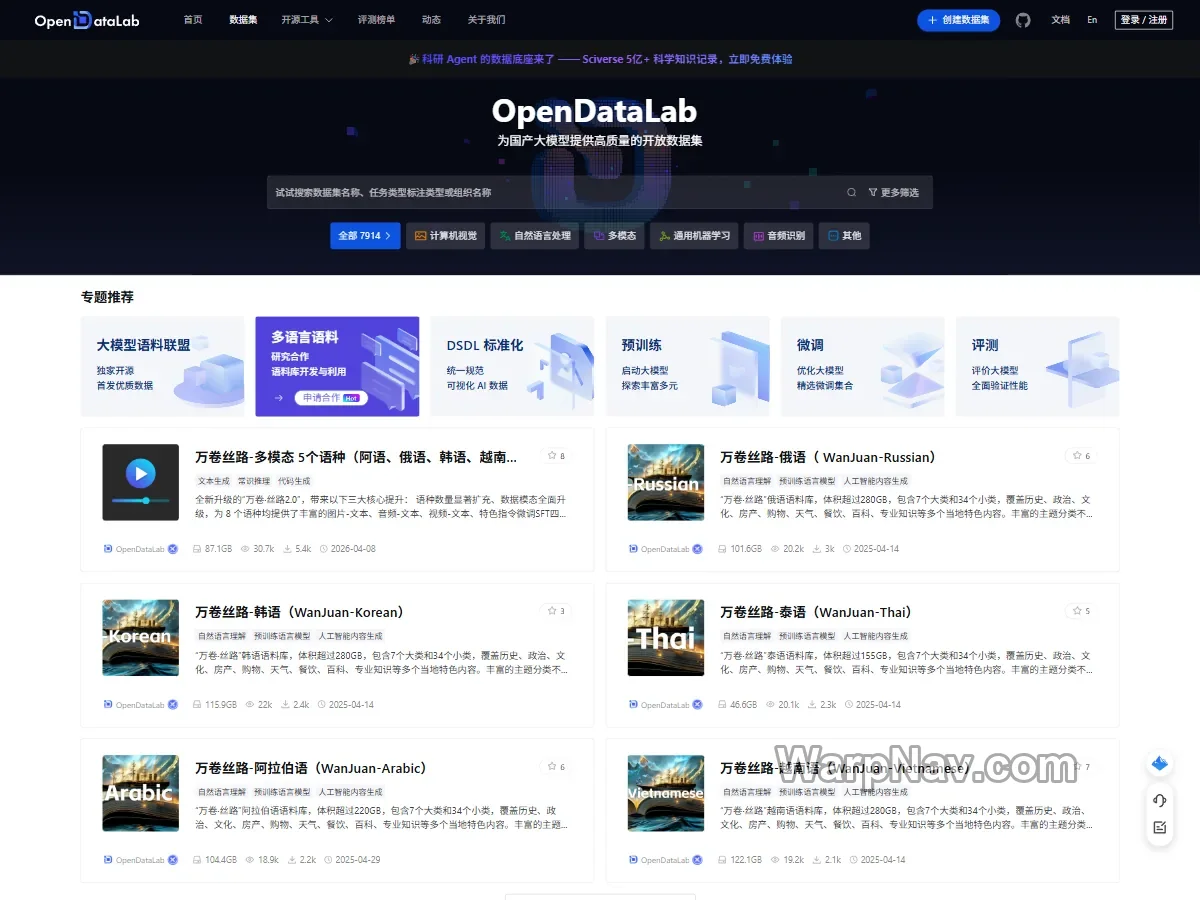
是面向人工智能研究与开发的数据集平台,集中展示文本、图像、音视频和多模态等多种数据资源,并提供搜索、结构化描述、在线查看以及网页、CLI 或 SDK 下载入口。它适合需要发现中文与多模态数据、比较任务类型或建立训练数据清单的研究者和开发者。
平台收录的数据来源包括公开汇聚、原创自制与合作共建,页面也会展示数据规模、任务、文件和来源等信息。不过,平台集合大量数据不代表所有条目拥有相同许可。数据集的原始权利、使用限制、人物隐私和下载条件应逐项核对,尤其不能仅凭“开放”或“免费”字样推断可用于商业模型。
用户可以围绕计算机视觉、自然语言处理、多模态、通用机器学习和音频等方向筛选数据。选型时不要只比较文件大小和样本数量,还应检查标注定义、类别分布、语言地区、采集时间以及训练集与测试集的划分方式。
数据集页面提供元信息、文件列表和说明入口,便于在下载前判断内容是否匹配任务。一个合格的内部数据清单应同时记录原始来源、版本、许可证、校验值、处理步骤和负责人;平台页面可以帮助发现信息,但不能替代项目自己的数据治理记录。
除网页下载外,官方文档还提供命令行与 Python SDK 的数据获取方式,适合需要重复下载或自动化环境的用户。批量使用前应查看当前账号权限、客户端版本和接口说明,并固定目标路径和数据版本,避免脚本在数据更新后得到不同结果。
| 环节 | 关键问题 | 建议产物 |
|---|---|---|
| 发现 | 任务、模态和规模是否匹配 | 候选数据清单 |
| 合规 | 许可、来源和隐私是否清晰 | 授权与风险记录 |
| 训练 | 偏差、重复和污染如何控制 | 版本化处理脚本 |
OpenDataLab 更适合作为 AI 数据发现、比较和获取入口。正式训练前可先抽样查看内容与标注,避免下载完成后才发现任务不匹配。把数据卡片与原始来源交叉核对,并为每次实验固定版本和处理记录,才能让训练结果更可靠。官网:https://opendatalab.org.cn/