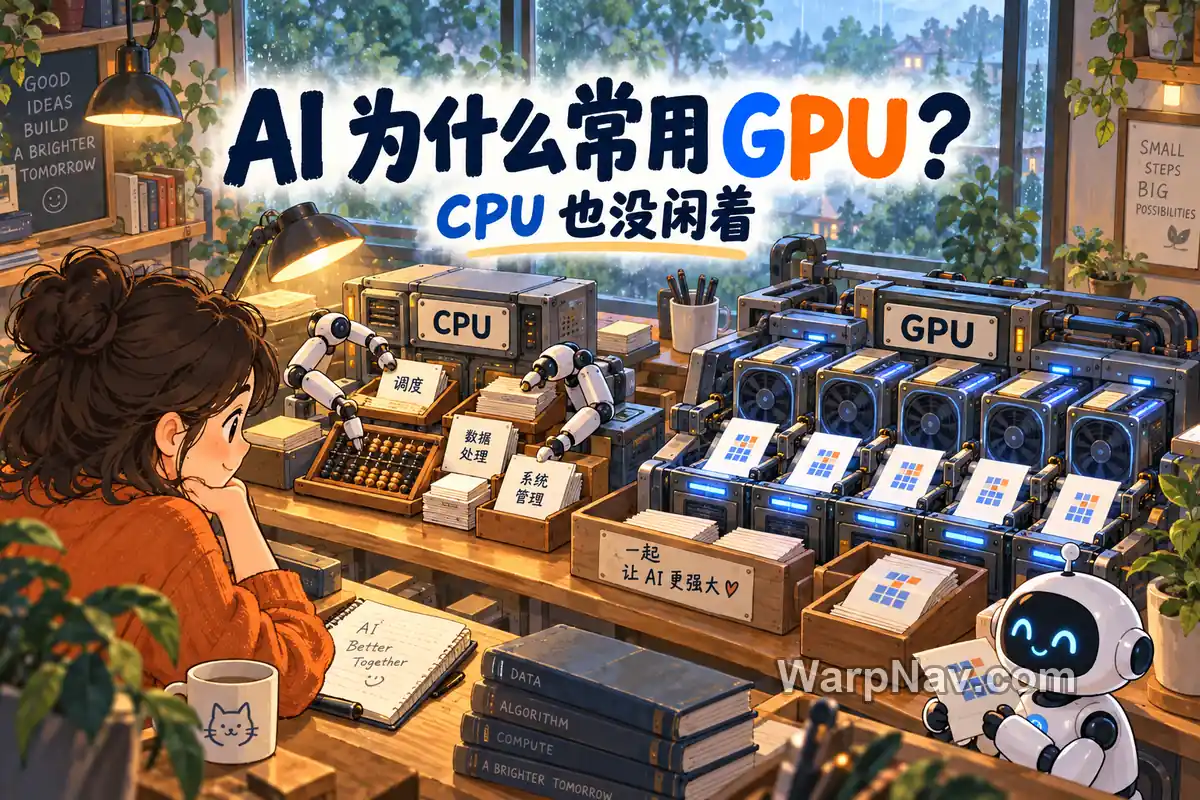
AI 常用 GPU,主要是因为神经网络里有大量适合同时处理的数值运算。CPU 则运行程序、准备数据、安排任务,也能直接计算模型。训练和回答问题都要完成这些工作,GPU 加速了其中的计算,不代表 CPU 只剩开机这件事。
处理图形的芯片,为什么能算 AI?
CPU 是中央处理器,负责执行电脑里的各种程序;GPU 是图形处理器,名字来自它处理图形的老本行。画面里有很多像素和图形数据,需要做大量相似计算,这推动了 GPU 向同时处理许多份数据的方向发展。后来人们发现,神经网络也有不少适合这种处理方式的计算。
文字进入模型后,会转成数字表示。模型内部再把这些数字与参数——训练得到的大量数值——组合起来,反复做乘法、加法等运算。很多计算能整理成一行行、一列列的数字表,这就是这里所说的矩阵。矩阵乘法听起来陌生,但其中一个基本动作就是:对应的数先相乘,再把结果加起来。
看一个专门为说明原理设计的小例子:给四行数据都执行“第一个数乘 2,加上第二个数乘 3”。(1,2) 得到 8,(3,4) 得到 18,(5,6) 得到 28,(7,8) 得到 38。四行使用同一种规则,而且这一行不必等上一行的答案,因而可以分开同时处理。真实模型里的规模大得多,计算关系也更复杂,但这种可并行的工作正是 GPU 的用武之地。
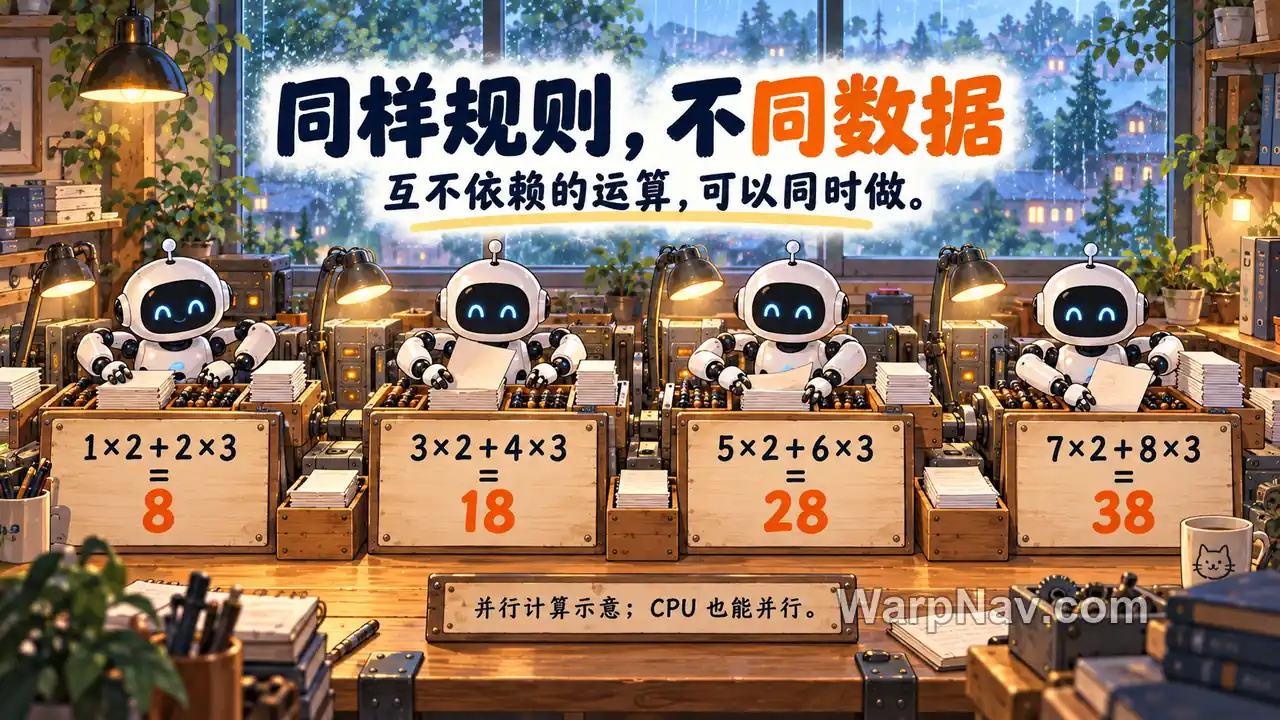
CPU 同样可以并行:它有多个核心,还能用一条指令处理多个数;某些 CPU 也带有矩阵加速能力。两者侧重不同,CPU 善于处理种类多、分支和依赖关系复杂的程序,GPU 更侧重大批相似运算的吞吐量。这里的吞吐量,说的就是单位时间完成多少计算。CPU 核心和 GPU 核心的能力不同,数量不能直接换算成性能倍数。
GPU 还可以有专门的计算单元。例如 NVIDIA 的 Tensor Core 用来加速矩阵乘加,配套计算库会把模型操作安排成硬件擅长的形式。芯片支持什么、模型要算什么、软件怎样安排,三者对得上才能发挥优势。
训练时,CPU 不只是给 GPU 发号施令
如果还分不清这两个阶段,可以先看训练与推理有什么区别:训练会调整参数,普通回答则使用已有参数。
训练要反复做几件事:让模型处理样本,衡量输出与训练目标的差距,再计算调整参数所需的信息,并更新参数。其中常用的梯度,描述参数发生微小变化时,误差会怎样变化;优化算法据此决定怎样调整。大型神经网络中,这些步骤包含大量数值运算,适合交给 GPU 等加速器。
但样本不会自己从硬盘整整齐齐地跳进 GPU。在常见训练程序里,CPU 上运行的进程要读取数据、处理格式、把样本组成一批,再安排数据传输和计算任务;它还要运行训练程序的控制逻辑。GPU 忙着算这一批时,CPU 可以同时准备下一批,而不是全程站在旁边等。
显卡很强,训练也可能卡在别处:读取和准备样本跟不上,GPU 就要等;计算被切成许多小任务,安排任务也有开销。PyTorch 的性能指南讨论了如何让加载数据与训练计算重叠,以及怎样减少 CPU 到 GPU 传输造成的等待。
工作也可以换地方:部分预处理能放到 GPU,部分模型或优化器计算能放到 CPU。最终分工由程序和设备决定,并非 CPU 只负责调度、GPU 只负责运算。
你发出一句问题后,两者怎样配合?
假设一个聊天服务把模型放在 GPU 上运行,你输入“用三句话解释彩虹”。从收到问题到返回回答,可以分成三个容易观察的环节:
- 准备模型输入。服务接收请求,整理可用的对话,再把文字转成模型处理的 Token 编号。Token 是模型使用的文本片段单位,不一定等于一个字或一个完整单词。这类处理和请求调度常由 CPU 上的软件承担。
- 执行模型计算。GPU 用已经加载的模型参数处理输入,计算后续文本的候选结果。生成过程中仍然有大量数值运算,只是普通推理不需要像训练那样计算用于学习的梯度、更新参数。
- 把结果交回用户。服务将输出编号还原成文字,组织成响应,通过网络逐步发回页面。这部分也有 CPU 上运行的程序参与。
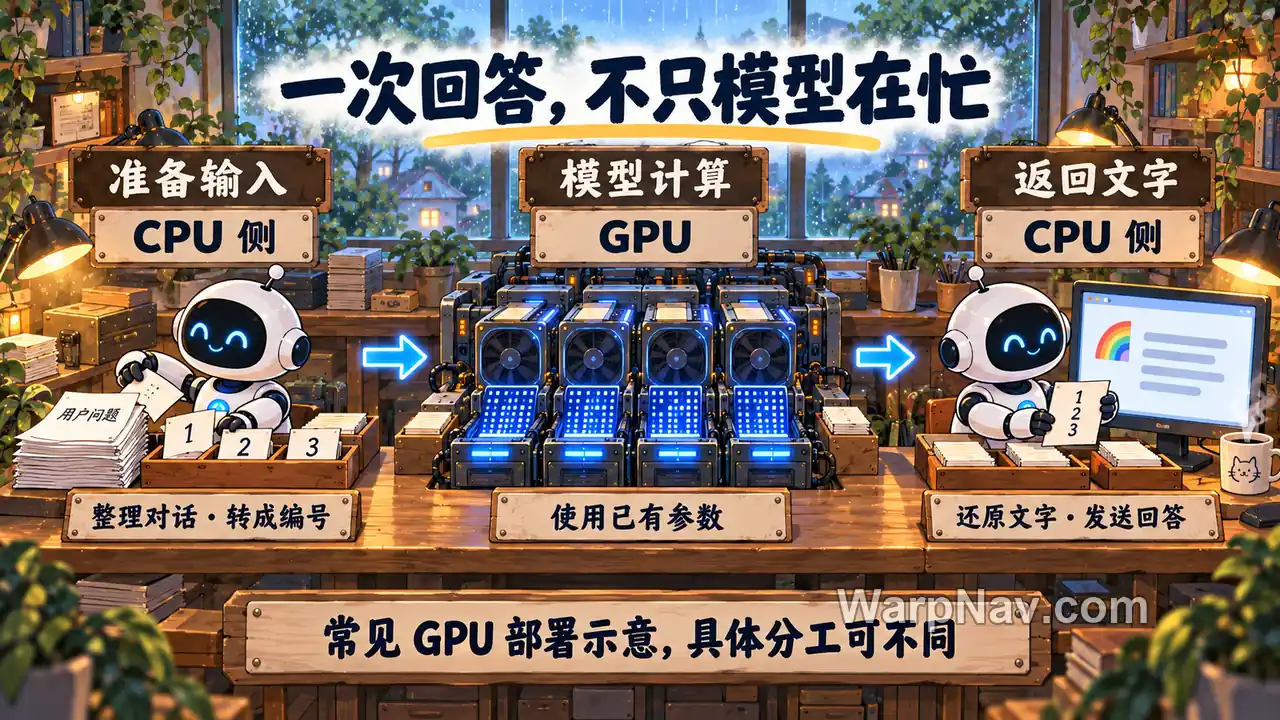
GPU 承担主要模型计算时,一次聊天请求仍有输入输出处理、调度和网络返回等工作。vLLM 的架构文档就把接口服务、调度与模型执行分开说明。上图省略了缓存、排队和多机协作,具体服务也可能合并或移动某些步骤。
还有个看似矛盾的地方:既然 GPU 能并行,为什么回答还会一个字接一个字地冒出来?常见语言模型按 Token 逐步生成,下一步会使用此前已经生成的内容,不能简单把整段未来答案完全独立地同时算完。可是生成一个 Token 所需的内部计算,仍有很多可以并行的部分;服务端也可以合并处理多个用户的请求。输出有先后,并不意味着芯片内部只有一个计算单元在干活。
算得快,还要装得下、搬得动
只盯着芯片的算力数字,很容易看漏另外两件事:模型和中间数据能否装进内存,以及这些数据能多快送到计算单元。
对于独立显卡,GPU 通常有自己的显存。运行模型时,除了参数,还需要给中间结果和生成过程中的缓存留空间;有些系统采用共享或统一内存,不能照搬“CPU 一份、GPU 一份”的图景。容量影响能放下多少东西,带宽影响每秒能搬多少数据,两者不是同一个指标。
比如,模型虽然装得下,计算单元却经常要等参数和缓存读过来,继续提高峰值算力也未必明显加快回答。反过来,装不下时采用拆分或在不同设备间搬运的办法,可能又增加等待。NVIDIA 的性能文档将计算、内存带宽和延迟分别讨论,就是因为限制速度的不总是同一环节。
同样用 GPU,训练快和回答快也不是一回事;显存更大,只能说明容量更大,不能单独说明生成更快。模型大小、数值存储方式、输入长度、同时处理的请求数和软件实现,都可能改变瓶颈。
没有独立显卡,能不能用 AI?
能,但先分清模型在哪里运行。如果你使用的是把模型部署在服务器上的网页聊天服务,本机主要负责浏览器、输入显示和网络通信,模型的大头计算在远端完成。此时为自己的电脑换一张高端显卡,通常不会让服务端生成文字更快;页面本身卡顿则是另一回事。
在本机运行模型时,CPU 可以直接做推理。llama.cpp 支持 CPU 运算、GPU 加速和混合执行:小模型、足够内存,加上可接受的等待时间,纯 CPU 也有用途;大型模型或大量并发请求则常常更适合加速器。具体速度要结合模型与机器判断,不能给 CPU 和 GPU 套一个固定的倍数。
没有独立显卡,也不一定只有 CPU:设备还可能有集成 GPU,或 NPU,也就是用于神经网络计算的处理单元;数据中心还可以使用其他专用加速器。GPU 是常见选择,AI 并不限于这一种芯片。
看见“支持 GPU 加速”,先看它加速哪一步。瓶颈如果在数据准备、传输或显存容量上,继续堆峰值算力未必能解决。
资料依据(核对于 2026 年 10 月 4 日):
NVIDIA:GPU Performance Background User’s Guide
https://docs.nvidia.com/deeplearning/performance/dl-performance-gpu-background/index.html
NVIDIA:Matrix Multiplication Background User’s Guide
https://docs.nvidia.com/deeplearning/performance/dl-performance-matrix-multiplication/index.html
PyTorch:Performance Tuning Guide
https://docs.pytorch.org/tutorials/recipes/recipes/tuning_guide.html
vLLM:Architecture Overview
https://docs.vllm.ai/en/latest/design/arch_overview.html
Intel:Comparing CPUs, GPUs, and FPGAs
https://www.intel.com/content/www/us/en/developer/articles/technical/comparing-cpus-gpus-and-fpgas-for-oneapi.html
Hugging Face:Optimizing LLMs for Speed and Memory
https://huggingface.co/docs/transformers/llm_tutorial_optimization
llama.cpp:项目说明与支持的硬件
© 版权声明
本站部分内容源于网络收集,文章等版权归原作者所有,若需删稿请联系管理员邮箱:satomini@warpnav.com
相关文章

暂无评论...
