看到 AI 提示用了“1000 Token”,不能直接把它换成 1000 个字或 1000 个词。Token 是模型处理文本的编码单位,常译作“词元”:一块可能是完整的词、词的一部分、标点或空格,也可能只对应组成汉字的一段字节。具体怎么切,由模型配套的分词器决定。计数前,要把文本和这套规则对上。
模型接到的,不是原封不动的一段文字
你输入一句话后,分词器会按既定规则把文字转换成一串 Token,再对应到数字编号,也就是 Token ID。模型使用这些编号对应的数值表示进行计算。编号只是词表里的索引,不是“这个词有多重要”的分数,也不是它含义的大小。
可以把这一步想成查排字抽屉:有的格子放一个字,有的放常见字串,有的放更小的片段。分词器根据词表和规则选出片段,并给出对应编号。抽屉只是“片段与编号对应”的类比;实际切分按规则完成,并不是先读懂整句话,再按意思分组。
生成回答时,方向反过来:常见文本模型逐步生成 Token 编号,程序再把它们解码成可读文字。你在页面上看到的逐字显示还会受到网络传输和界面刷新影响,每次屏幕跳出的内容不一定刚好是一个 Token。至于生成中的计算由哪些硬件完成,可以接着看CPU 与 GPU 在 AI 回答时的分工。
一个英文词,为什么会被拆成几块?
如果把每一种可能出现的完整词都收进词表,生僻词、新名字和各种拼写变化会让词表很难照顾周全;如果一律拆成单个字符,常见表达又会变成长长的一串。许多分词器因此采用子词思路:常见片段可以整块表示,其他文本再由较小的片段组成。这些片段不一定是学校里学的词根或词缀。
一个英语单词也可能占好几个 Token。OpenAI 的 tiktoken 计数教程中,antidisestablishmentarianism 在 cl100k_base 编码下拆成六块:
ant | idis | establish | ment | arian | ism
竖线只是这里标出的边界,不属于原文。它在日常英语里是一个单词,在这套编码里却是 6 个 Token。自然语言中的词与分词器切出的片段,边界并不相同。
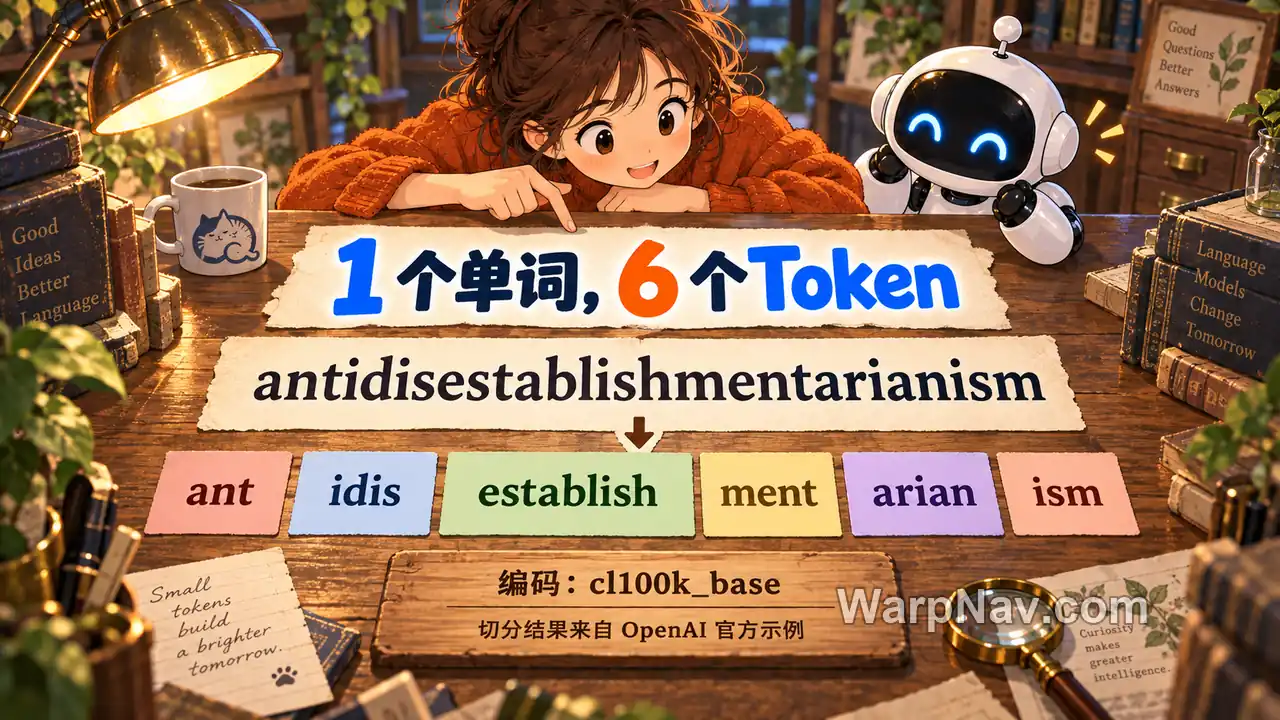
同一官方示例里,r50k_base 将它切成 5 块,其中 establishment 保持一整块。这里的编码名称指向不同的词表与规则,不是“精确模式”和“粗略模式”。两套结果各自成立,不能把其中一套的数量直接套到另一套模型上。
分词方式也不只一种。BPE、WordPiece 和 Unigram 等算法建立词表、选择片段的方法不同。计数必须匹配模型的分词器,否则即使输入相同,算出的数量也可能不同。
中文、空格和标点,都没有固定兑换率
中文没有靠空格隔开每个词,但分词器照样可以编码。它可能把常见的几个字合成一个 Token,也可能让一个字对应一个或多个 Token。遇到少见字符时,某些字节级分词器会继续拆分;这里的字节是电脑存储文字的单位,一个汉字在常见的 UTF-8 编码中通常要用多个字节表示。
因此,某个 Token 对应的字节片段可能单独显示不成完整字符,要和相邻片段拼起来才能还原。把每块都画成一个完整汉字,会掩盖这种情况:并非每个 Token 都能独立读出来。
空格和标点也参与编码,不是默认免费的填充物。有时空格会和后面的字串放进同一个 Token,有时单独成块。官方教程里同一段文本 2 + 2 = 4 就出现了这样的差异。下表用 ␠ 代表原文中的一个空格,它是展示记号,不是另加进输入的字符:
| 编码 | Token 边界示意 | 数量 |
|---|---|---|
r50k_base |
2 | ␠+ | ␠2 | ␠= | ␠4 |
5 |
cl100k_base |
2 | ␠+ | ␠ | 2 | ␠= | ␠ | 4 |
7 |
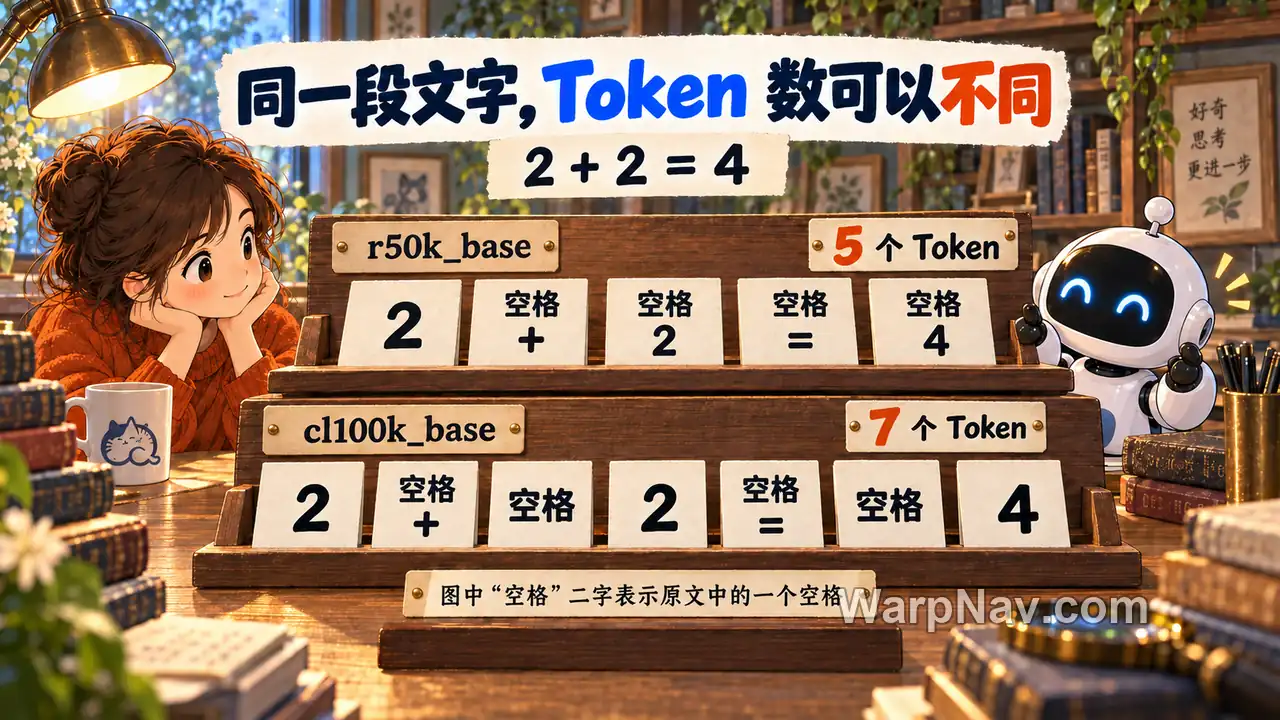
这两行并不是改了算式,也不是第二套算法“算错了”,只是对空格和数字采用了不同的组合方式。给英文加个前导空格、换大小写、插入换行,都可能改变分词结果;不能先把这些字符删掉再计数,却说测的是原文。
你可能还见过“一个 Token 约等于四个字符”或“四分之三个单词”的说法。OpenAI 将其明确用作英文文本的粗略经验值,不是逐句成立的公式。中文、代码、网址、表情符号和混合文本都不适合直接照此换算。模型之间 Token 更少,也不能单凭这一项断定谁理解得更好。
上下文长度和用量,数的又是哪一份?
界面中的用量和长度,可能数的是不同内容:
- 输入 Token:这次请求交给模型处理的内容,可能不止你刚发的一句话,还包括被带入的历史对话、系统指令、工具说明和检索资料。
- 输出 Token:模型这次生成的内容。具体接口还可能把不可见的推理或结构标记计入输出用量,不能保证与最终显示的正文数量完全一致。
- 上下文窗口:一次处理能容纳的 Token 范围。输入与生成内容的预算、单独的输出上限,需要按具体模型和产品规则看;窗口大小不等于可上传同样数量的汉字,也不等于永久记忆容量。
假如你只补了一句“再简短些”,应用仍可能把前面的长对话一起送入模型,所以新增输入很短,不代表整次输入就很短。反过来,应用也可能截取、摘要或检索历史,而不是每轮都带上全部记录。屏幕上能翻到什么,与模型本次实际收到什么,需要分开看。
API 按 Token 计费时,还可能区分输入、输出和缓存等类别;聊天产品的订阅、次数限制则是另一套规则。Token 说明用量,单价和额度由产品规定。就像用电量还要乘上电价才能算费用,只有 Token 数也算不出账单。
要数准确,先把模型和原文对上
只想了解一小段纯文本如何切分,可以用服务商的分词工具,确认选的是对应模型或编码,再粘贴原文,连空格和换行一起保留。观察切分块和总数,比让聊天模型凭感觉报一个数字可靠。不同编码结果不同,也正好能帮助你检查自己是否选错了工具。
若要估算真正的 API 请求,只数聊天框里的正文还不够。消息角色、边界标记、工具定义,以及图片或音频等内容可能采用额外的计数方式。OpenAI 的计数文档就明确区分了本地纯文本分词与完整请求计数;需要对账时,应看对应服务的计数接口和实际用量记录。
为了省 Token,把必要标点全删掉、将清楚的话硬缩成暗号,未必划算:数量不一定按字数同比下降,意思却可能先变模糊。更值得删的是与任务无关的长资料和重复说明。先把需求讲清,再检查实际 Token 数,通常比追求一套“每个字值几个 Token”的口诀更有用。
资料依据(核对于 2026 年 10 月 5 日):
OpenAI:Key concepts
https://developers.openai.com/api/docs/concepts
OpenAI:How to count tokens with Tiktoken(本文两组具体切分示例来源,非本地实测)
https://developers.openai.com/cookbook/examples/how_to_count_tokens_with_tiktoken
OpenAI:Counting tokens
https://developers.openai.com/api/docs/guides/token-counting
Hugging Face:Tokenization algorithms
https://huggingface.co/docs/transformers/tokenizer_summary
Hugging Face:The tokenization pipeline
https://huggingface.co/docs/tokenizers/main/en/pipeline
tiktoken:分词库与 BPE 说明
© 版权声明
本站部分内容源于网络收集,文章等版权归原作者所有,若需删稿请联系管理员邮箱:satomini@warpnav.com
相关文章

暂无评论...
