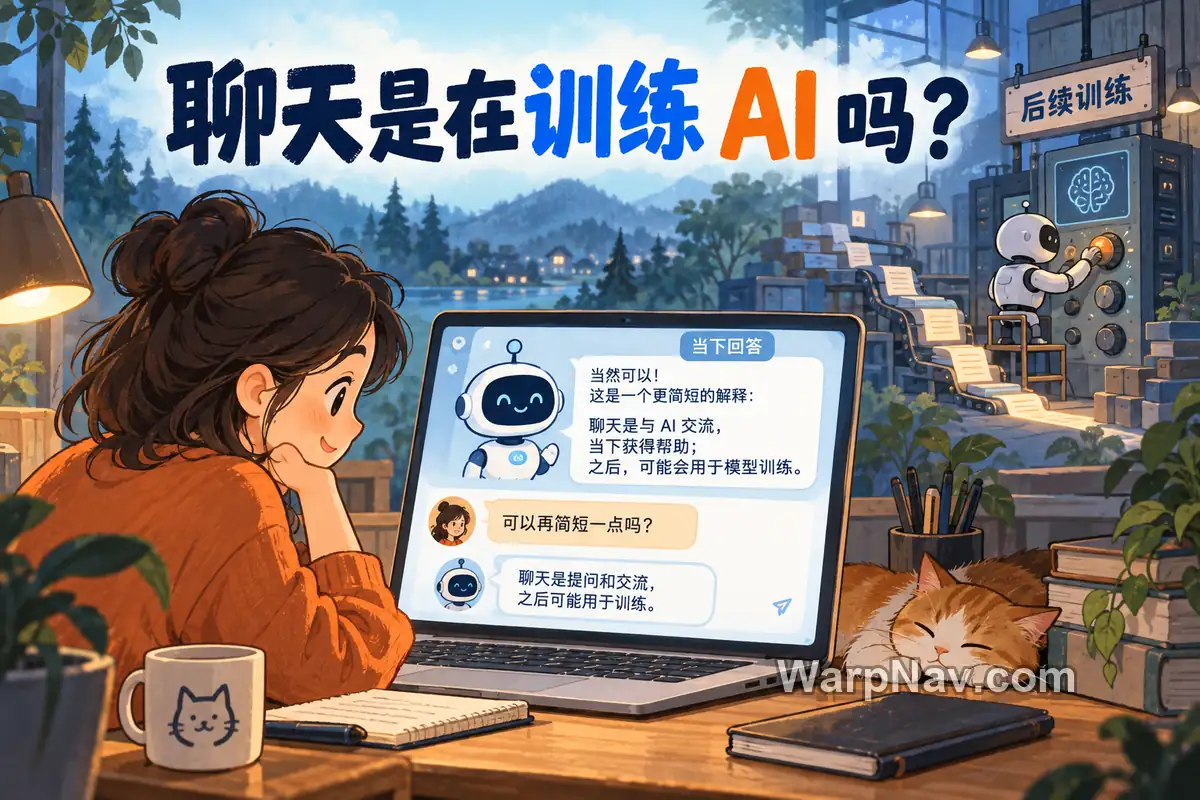
通常不是。你和 AI 聊天时,模型会用已经训练好的参数处理当前问题并生成回答,这一步叫推理。你补充一句要求,它马上换种答法,通常是因为这句话进入了本轮可用的对话内容,并不表示模型参数当场被改写。训练是另一件事:用数据调整模型参数。还有一个容易混淆的问题——聊天内容将来是否可能被服务商用于训练新模型,要看产品政策与设置,不能从这次回答的变化直接推断。
它听了我的话,改变的是什么?
设想你问 AI:“解释一下什么是光合作用。”它给出一段偏专业的回答;你接着说:“用三句话讲给小学生听。”第二次回答明显变短了,也换了更简单的词。
这里新加入的是本轮输入中的要求。聊天应用会把当前问题和相关的对话内容交给模型,模型据此生成下一条回复。回答能随要求变化,说明它在使用眼前的信息,不足以说明它把“以后都用三句话回答”写进了模型本身。
哪些历史内容还能进入下一次回答,取决于具体产品的上下文管理:可能保留、截取、摘要或另行检索。不能因为屏幕上还看得见整段聊天,就断定模型每次都完整读到了全部记录。
训练:把规律写进模型参数
模型参数可以粗略理解为训练后得到的大量数值。训练时,开发者让模型处理许多样本,比较输出与训练目标,再反复调整这些数值。调整完成后,得到可供使用的模型版本。之后也可能通过微调等方式继续更新,但那仍是一次独立的训练过程。
所以,“训练 AI”不是用户每说一句话,它就把这句话原样存成永久知识。训练要不要采用某些对话数据、如何筛选与处理,是开发者和服务商另外决定的事;即使某段内容后来被用于训练,也不能据此保证新版模型会准确记住那段话。
推理:用现有模型回答眼前问题
模型开始回答时,会处理这次输入,结合已经训练出的参数,逐步生成输出。对于通常部署的聊天式大语言模型,这个生成过程不会一边回答、一边把参数更新成新版本。IBM 对大语言模型推理的说明也明确区分了“生成输出”与训练中的权重更新。
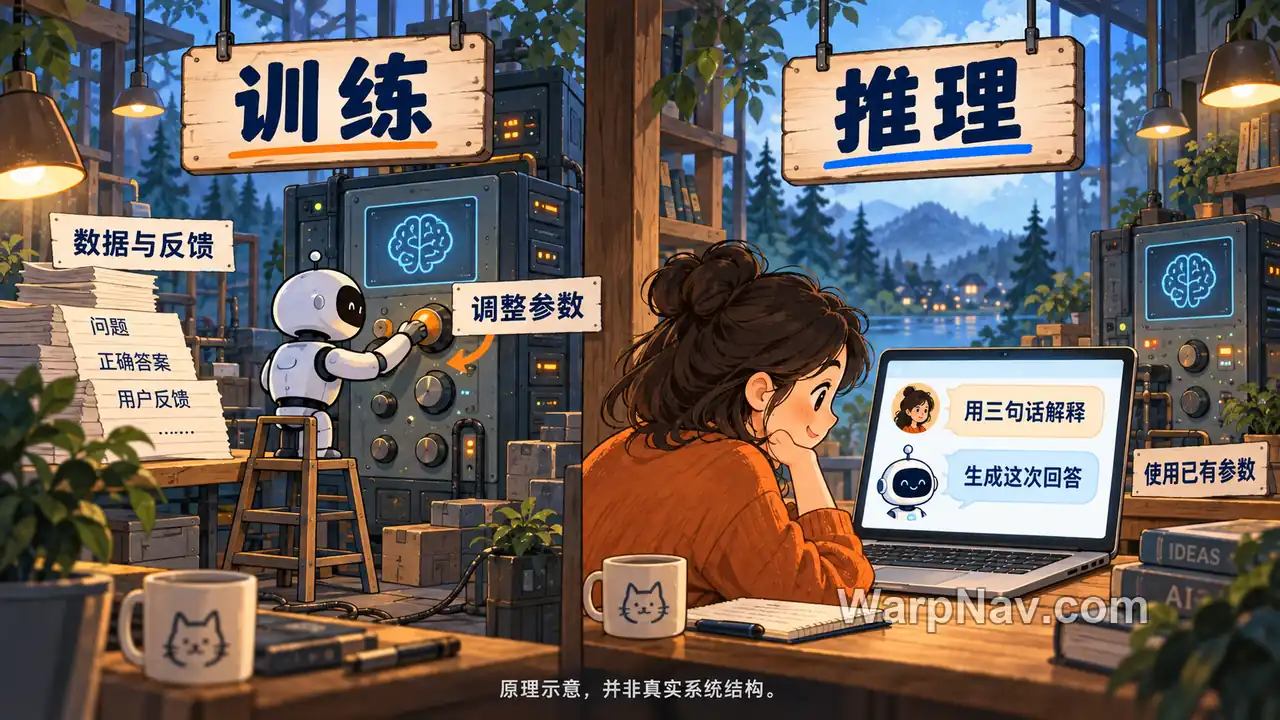
“推理”在这里是机器学习里的用词:训练好的模型投入使用,针对新输入产生结果。它不要求每个问题都经历人类意义上的复杂思考。日常所说的“让 AI 多想一会儿”和这里的训练/推理划分,也不是同一个分类标准。
这不代表推理不耗算力。模型每生成一段回答仍要计算;只是计算出这次回答和修改模型参数,目的与过程不同。
“它记住了我”,也未必是训练
同一句“AI 记住了”,背后至少可能是三种不同情况:
- 当前对话的上下文:你刚交代的“三句话回答”被用于后续回复;它影响这次或接下来的输入,不等于修改模型参数。
- 产品保存的记忆或历史信息:某些聊天产品可在以后把保存的信息重新提供给模型。以 ChatGPT 为例,OpenAI 说明已保存的记忆与聊天记录分开保存,并可用于后续回答;这仍不能直接等同于训练模型。
- 后续模型训练:服务商在另一时间收集、筛选并使用符合其政策的数据,训练或改进模型版本。即便数据来自聊天,也不是“你发出消息的同时,所有人的模型马上学会了”。
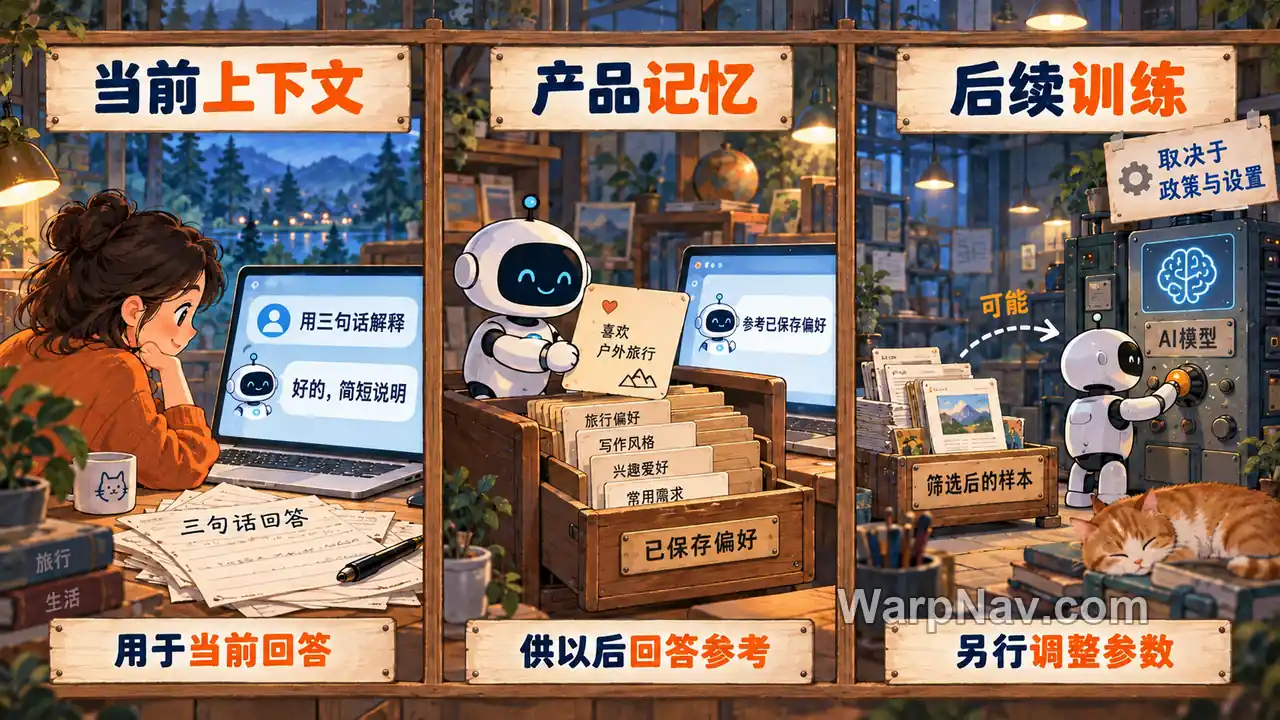
把这三层分开,很多看似矛盾的现象就好解释了:AI 可以在这段对话里照着你的新要求做,也可能在另一段对话中参考产品保存的记忆;两种情况都不能单独证明底层模型参数发生了变化。
那聊天内容会用于以后的训练吗?
有可能,但没有适用于所有 AI 产品的统一答案。以 2026 年 9 月 27 日核对的 OpenAI 官方说明为例,个人 ChatGPT 服务的内容可能被用于改进和训练模型,用户可以选择退出;ChatGPT Business、Enterprise 和 API 等商业服务默认不拿输入输出训练模型。具体服务、账户和设置要按各自当前政策判断,不能把这组规则套到别家产品上。
这里的时间顺序很关键:本次聊天中的推理,与未来是否把聊天资料纳入训练,是两项不同的事。你看到回答立刻顺着要求改变,主要能说明它使用了当前可用的信息;想知道数据会不会进入后续训练,需要看该服务的数据使用说明,而不是观察它这一句答得有多像“学会了”。
资料依据(核对于 2026 年 9 月 27 日):
IBM:What is LLM Inference?
https://www.ibm.com/think/topics/llm-inference
Cloudflare:人工智能推理与训练
https://www.cloudflare.com/zh-cn/learning/ai/inference-vs-training/
Google Research:Learning without training: The implicit dynamics of in-context learning
https://research.google/pubs/learning-without-training-the-implicit-dynamics-of-in-context-learning/
OpenAI:ChatGPT 中的记忆
https://help.openai.com/zh-hans-cn/articles/8590148-memory-in-chatgpt
OpenAI:How your data is used to improve model performance
https://openai.com/policies/how-your-data-is-used-to-improve-model-performance/
© 版权声明
本站部分内容源于网络收集,文章等版权归原作者所有,若需删稿请联系管理员邮箱:satomini@warpnav.com
相关文章

暂无评论...
