llama.cpp 是一套用 C/C++ 写的本地大模型推理库和工具,用来在自己的电脑或服务器上跑文本和多模态模型,不必把数据送到云端。2026 年 11 月 13 日 18:20(Asia/Shanghai),项目发布了 v1.0.0,这是它约三年半以来的第一个正式大版本:公开 C API 删掉了 35 个已弃用接口,并承诺以后用不兼容的改动会抬主版本号。同一天,底层张量库 ggml 也到了 v1.0.0。对只想聊天的人来说,用站内介绍过的 Ollama 通常更省事;llama.cpp 更底层,适合要自己选量化、开兼容 OpenAI 的接口,或把推理嵌进应用里的人。
它处在哪一层
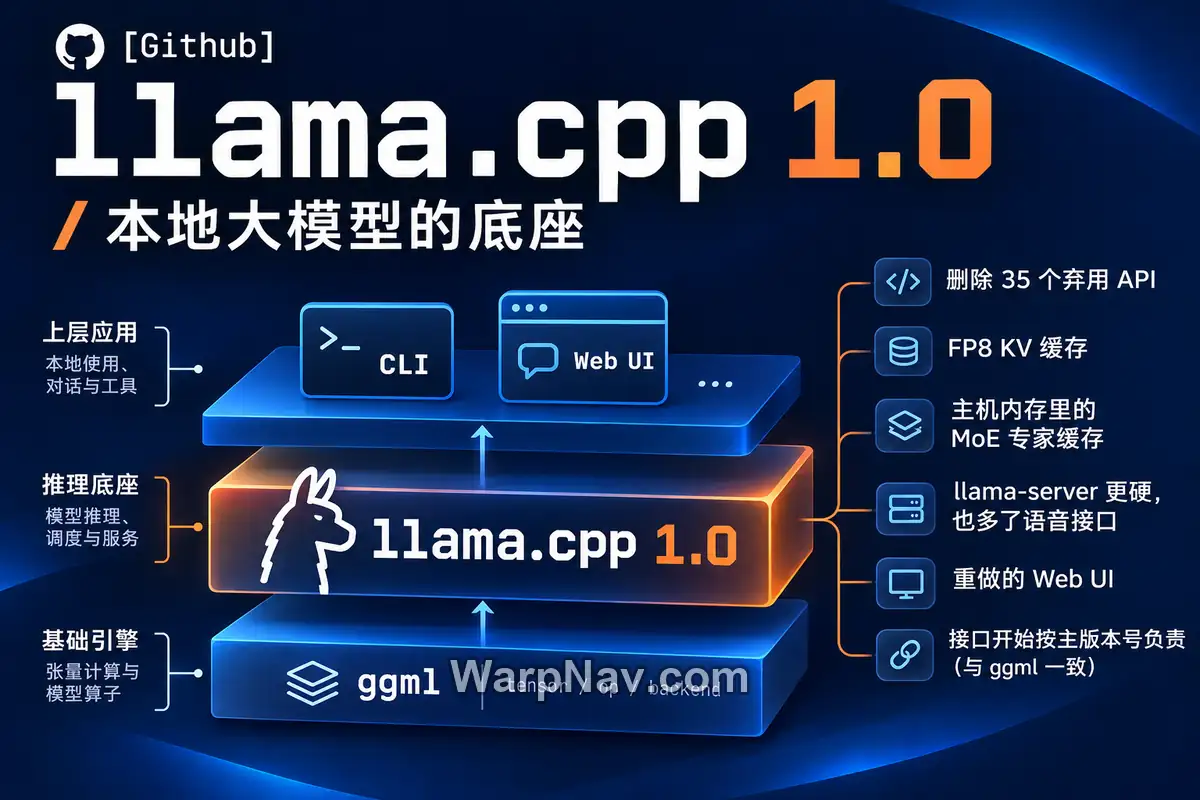
本地跑模型可以粗分成三层。最底下是张量运算库 ggml,负责在 CPU、Apple Silicon 的 Metal、NVIDIA CUDA、AMD HIP、Vulkan 等后端上算矩阵。中间是 llama.cpp:读 GGUF 模型、管理上下文和 KV 缓存、做采样,并提供命令行和 HTTP 服务。再往上才是各种桌面应用和套壳工具,把模型下载、对话窗口和开关收成更友好的界面。
官方说明里把 llama.cpp 定位为跨硬件、可量化的轻量推理平台,强调隐私和本地部署。Hugging Face 上的项目博客写得更直白:过去三年半已经有许多下游应用依赖这套库接口,所以 1.0 的重点不是再堆一个演示功能,而是把对外接口收成可以长期依赖的版本。
站内解释过 AI 为什么常用 GPU、CPU 在推理里做什么。llama.cpp 的实际用法常常是两者一起上:显存够的层放 GPU,放不下的权重和专家可以留在内存里算,这也是 1.0 里 MoE 专家缓存要解决的问题。
1.0 真正改了什么
发行说明很长,对大多数使用者,值得先记住这几件事。
接口开始按主版本号负责
以后 llama.cpp 和 ggml 只要公开 C API 出现不兼容变更,就会升主版本号;向后兼容的功能和模型支持升次版本,纯修复升补丁号。v1.0.0 自己先做了一次清理:从 llama.h 移除 llama_set_warmup、35 个已弃用函数,以及 defrag_thold / --defrag-thold;把原先放在扩展头里的 NextN(推测解码)接口提升到 llama.h,并把 llama_set_embd_state_src 改名为 llama_set_ctx_state_src。如果你的程序直接链的是 libllama 而不是只调用命令行,升级前要对照自己用过的符号,不能假定旧调用还能编过。
FP8 KV 缓存
对话一长,KV 缓存就会和上下文长度一起涨,显存往往比模型权重先告急。1.0 加入了 OCP FP8 格式的 KV 缓存,可用 -ctk f8_e4m3 -ctv f8_e4m3,并支持可选的静态 per-tensor 缩放。官方服务器文档里,K/V 缓存还允许 f32、f16、bf16、q8_0、q4_0 等类型,默认仍是 f16。这不是免费的压缩:精度和速度要在具体模型上自己看,具体模型上的精度和速度仍需比较,不能理解成「开了就又快又省」。
给内存中的专家加 GPU 缓存
混合专家(MoE)模型总参数可以很大,但每个 token 只激活其中一部分专家。1.0 把专家缓存的容量和「未命中时有多少改由 CPU 计算」写进了上下文参数(moe_cache_size、moe_cache_cpu_share),替换策略是 LRFU / ClassLRU,已缓存的专家不再让 GPU 空等 CPU。命令行里对应的是 --moe-cache-mib(给已经放在 CPU 上的专家准备的 GPU 缓存,单位 MiB,默认 0 即关闭)和 --moe-cache-cpu-share(缓存已满且未命中时,由 CPU 直接计算、而不再上传 GPU 的比例,0 到 1,默认 0)。配合原有的 --cpu-moe / --n-cpu-moe,可以把部分或全部专家放在内存里,只把常用的送进显存。这和本周多款大 MoE 开放权重是对得上的,机制说明见同日的 MoE(混合专家)模型解释。
llama-server 更硬,也多了语音接口
内置 HTTP 服务做了针对 SSRF、CORS、DNS rebinding 的加固,并支持取消 MCP 工具调用。同一次发布还加了兼容 OpenAI 的 /v1/audio/speech 端点,以及 /tts 的 temperature 选项。如果你把服务绑到局域网或公网,这些安全改动是升级理由之一,但加固不等于可以随便裸奔到公网,端口和访问控制还是要自己设。
重做的 Web UI
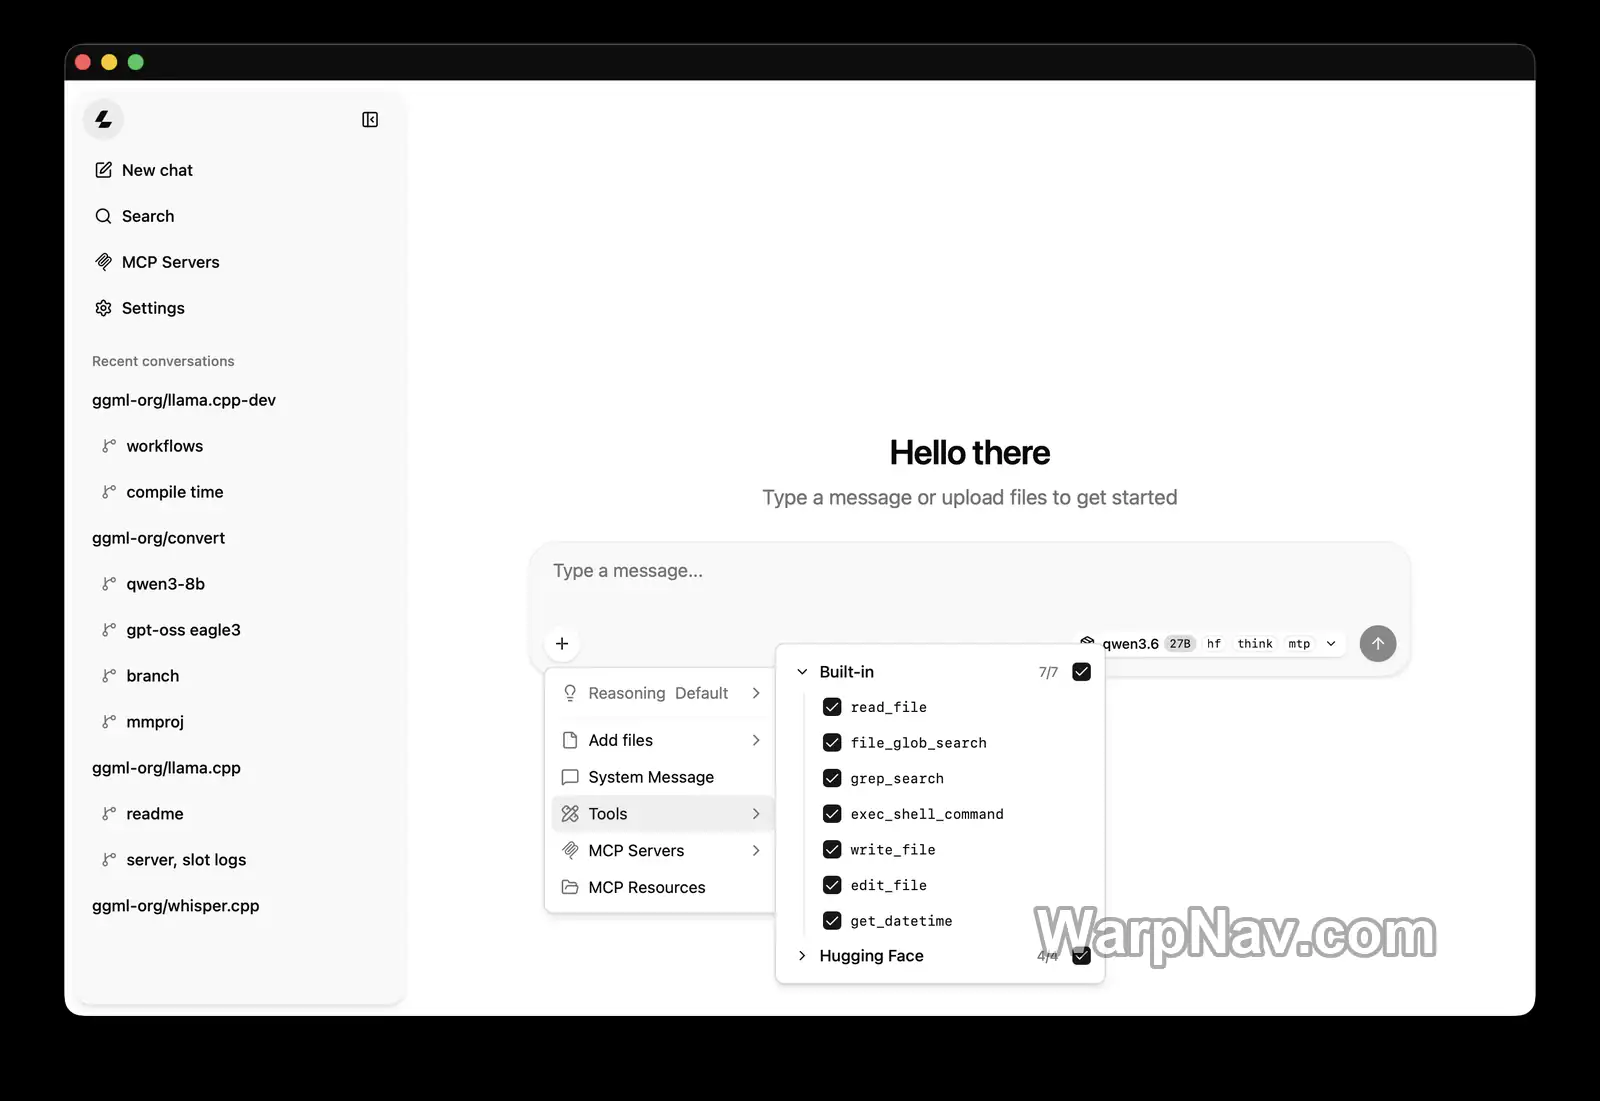
发行说明概括为:重新设计的 Web UI,带对话分组和 Markdown 编辑器。提交记录里还能看到侧边栏整理、手机上更接近原生应用的交互、PDF 附件缩略图、右键操作等,这些属于界面细节,不是新的推理能力。当前仓库 README 用 llama serve 启动带 Web UI 的服务;发行说明里仍写作 llama-server,如果你本机命令对不上,以当前文档和 --help 为准。
模型和后端,点到为止
1.0 新接入的文本架构包括 Kimi-K3.1-Pro、Ripple 和 xing4_0,另外还有 drama-3 TTS,以及 MageVL-Cowork、Kimi-K3.1 的视觉支持。官方博客称目前支持 150 种以上架构变体,以及主流推测解码方法。这些名单会继续变,选模型时仍以仓库文档和 Hugging Face 上的 GGUF 卡片为准。站内介绍过的 Gemma 4 这类开放权重模型,常见用法也是先换成 GGUF,再用 llama.cpp 或它的下游工具来跑。
怎么安装
按 2026 年 11 月 14 日读取的官方 README,常用途径是这些:
- 用官方安装脚本:Linux 和 macOS 可用
curl -LsSf https://llama.app/install.sh | sh;Windows PowerShell 可用irm https://llama.app/install.ps1 | iex。脚本会从网络执行,先读脚本内容再决定是否跑,比直接管道执行更稳妥。 - 打开 https://llama.app 按页面说明安装。
- 用 Docker,步骤见仓库里的 Docker 文档。
- 从 GitHub Releases 下载预编译包。v1.0.0 说明本身没有在本文核验时列出完整二进制清单,下载时认准官方仓库的 Releases 或 llama.app,不要用来路不明的镜像包。
- 克隆仓库按官方 build 指南自行编译,需要特定后端(CUDA、Metal、Vulkan 等)时走这条路最清楚。
官方 1.0 博客还把 Debian、Homebrew、conda-forge、MacPorts、Winget、XCFramework 列为发行渠道。本文没有逐一核对各渠道当天的包版本,所以不代写那些安装命令,以免和你系统里的实际包名不一致。
装好后,README 给的最小例子是直接从 Hugging Face 拉一个小模型:
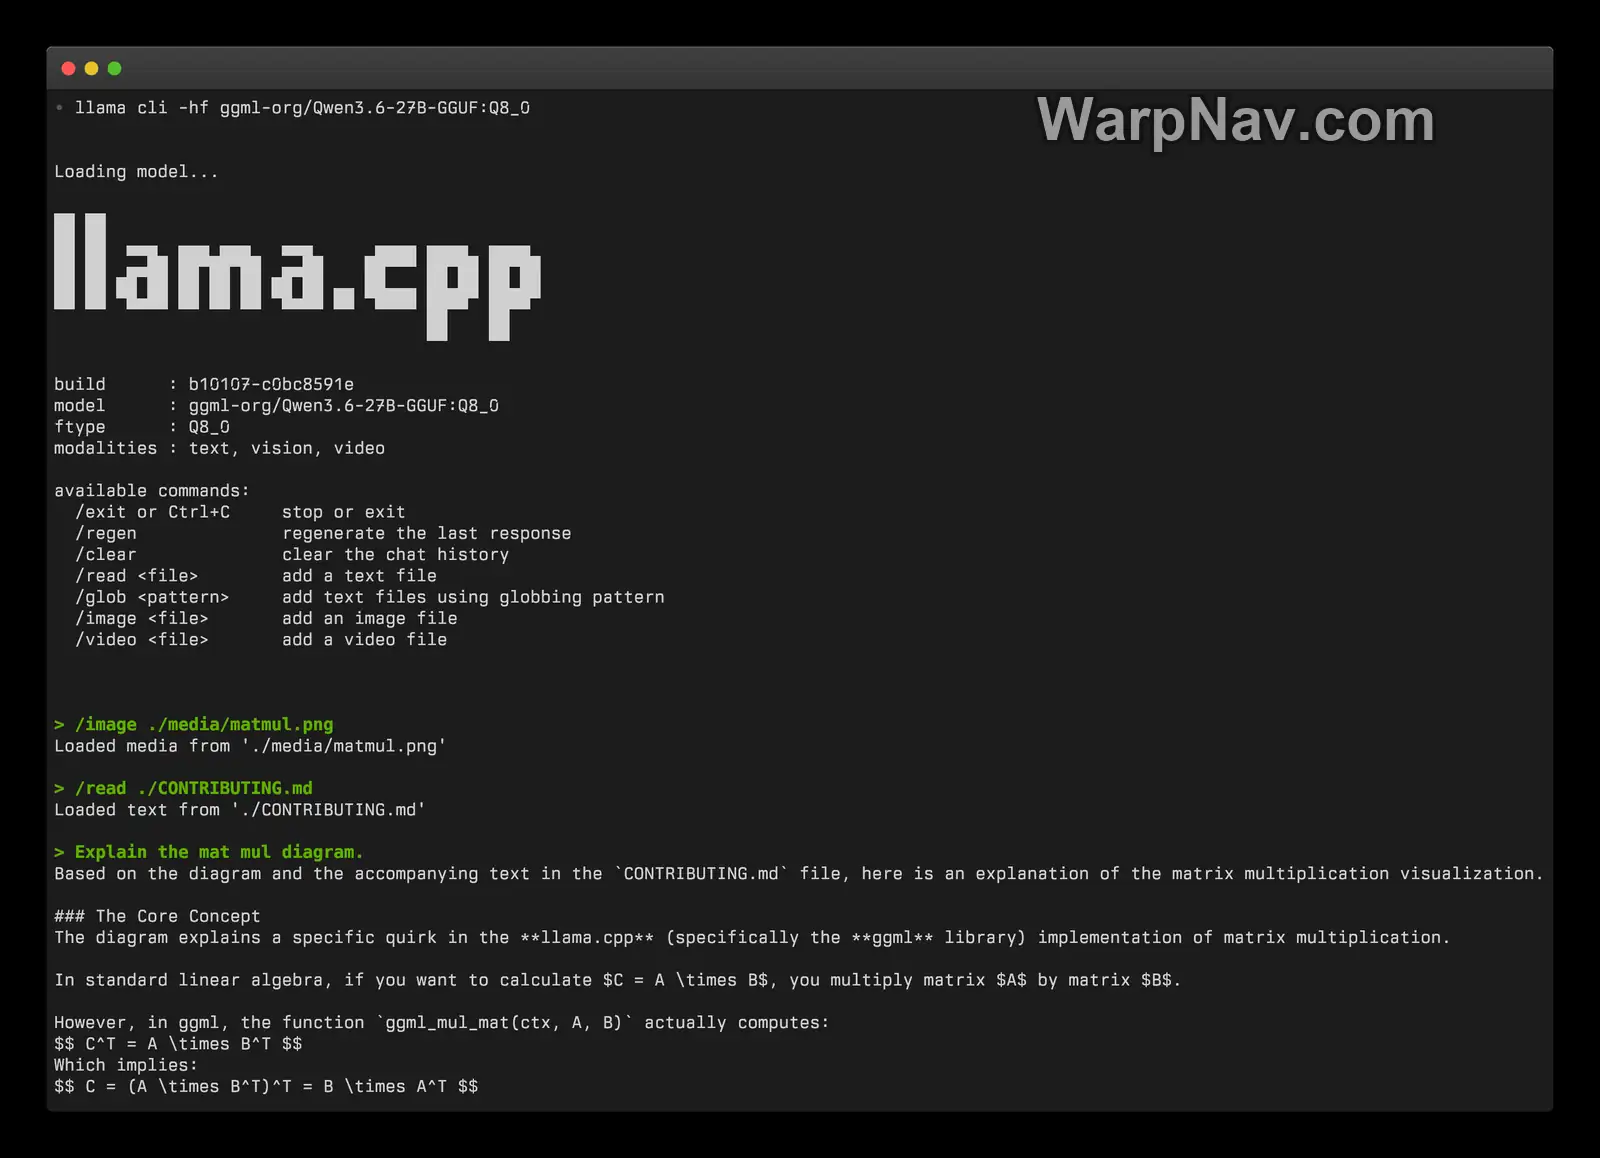
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF
第一条在终端里对话,第二条打开兼容 OpenAI 的服务,并用浏览器看内置 Web UI。模型要换成本地已有的 GGUF 路径也可以,具体参数以当前命令的帮助为准。第一次跑会下载模型,注意磁盘和内存够不够。
什么时候值得直接用它
如果你只是想在本机和模型聊天,先装 Ollama 或其它桌面套壳,通常更快。llama.cpp 更适合这几类需求:要自己挑 GGUF 量化和上下文长度;要把兼容 OpenAI 的 HTTP 接口嵌进已有程序;需要 FP8 KV 或 MoE 专家缓存这类更细的开关;或者在官方列出的多种后端上编译,针对某一块硬件做裁剪。1.0 让后两种人更有理由跟进:接口开始按主版本号承诺稳定性,同时把显存和 MoE 的新选项做进了正式版。
模型文件方面,常见来源是 Hugging Face 上的 GGUF 仓库。可以用 llama cli -hf 用户名/仓库名 直接拉,也可以先下载到本地再指定路径。选文件时看清楚量化后缀和是否需要单独的投影器(mmproj)才能跑视觉或语音,不要只看仓库星标。
从旧版本升上来要注意什么
对只使用命令行、且没有依赖已删除参数的人,1.0 更像一次功能更新。对直接调用 C API 的应用、绑定和插件,这是一次破坏性升级:那 35 个弃用函数和更名接口不会再编过。发行说明里还提到多模态侧删除了 clip.h,相关能力收进 mtmd,做视觉或语音封装的项目要一起看。
官方把 1.0 的意义写成对下游开发者负责。反过来说,1.0 之后如果再出现不兼容的公开 API 变更,按他们自己的规则就该走到 2.x。在依赖里锁定大版本,比默默跟踪 nightly 构建要安全。
本文没有在本机实际编译或跑通 v1.0.0,上面的命令和参数均来自官方 README、发行说明和服务器文档。遇到报错时,以你安装到的版本自带的说明为准。
项目信息
以下信息通过 GitHub API 和官方发行说明核对于 2026 年 11 月 14 日:
- 仓库:ggml-org/llama.cpp,2023 年 3 月 10 日创建,说明为 LLM inference in C/C++
- 许可证:MIT
- Star 约 13.49 万,Fork 约 2.56 万(API 记录为 134,914 和 25,584)
- 最新稳定版:v1.0.0,2026 年 11 月 13 日 18:20(Asia/Shanghai)发布;底层 ggml 同步为 v1.0.0
- 官网与安装入口:https://llama.app
项目地址:ggml-org/llama.cpp
1.0 发行说明:llama.cpp v1.0.0 发行说明
官方博客:https://huggingface.co/blog/ggml-org/llama-cpp-v1
服务器文档:llama-server 服务器文档
© 版权声明
本站部分内容源于网络收集,文章等版权归原作者所有,若需删稿请联系管理员邮箱:satomini@warpnav.com
相关文章


暂无评论...
