
FireCrawl
分清 Scrape、Map、Crawl 并控制额度
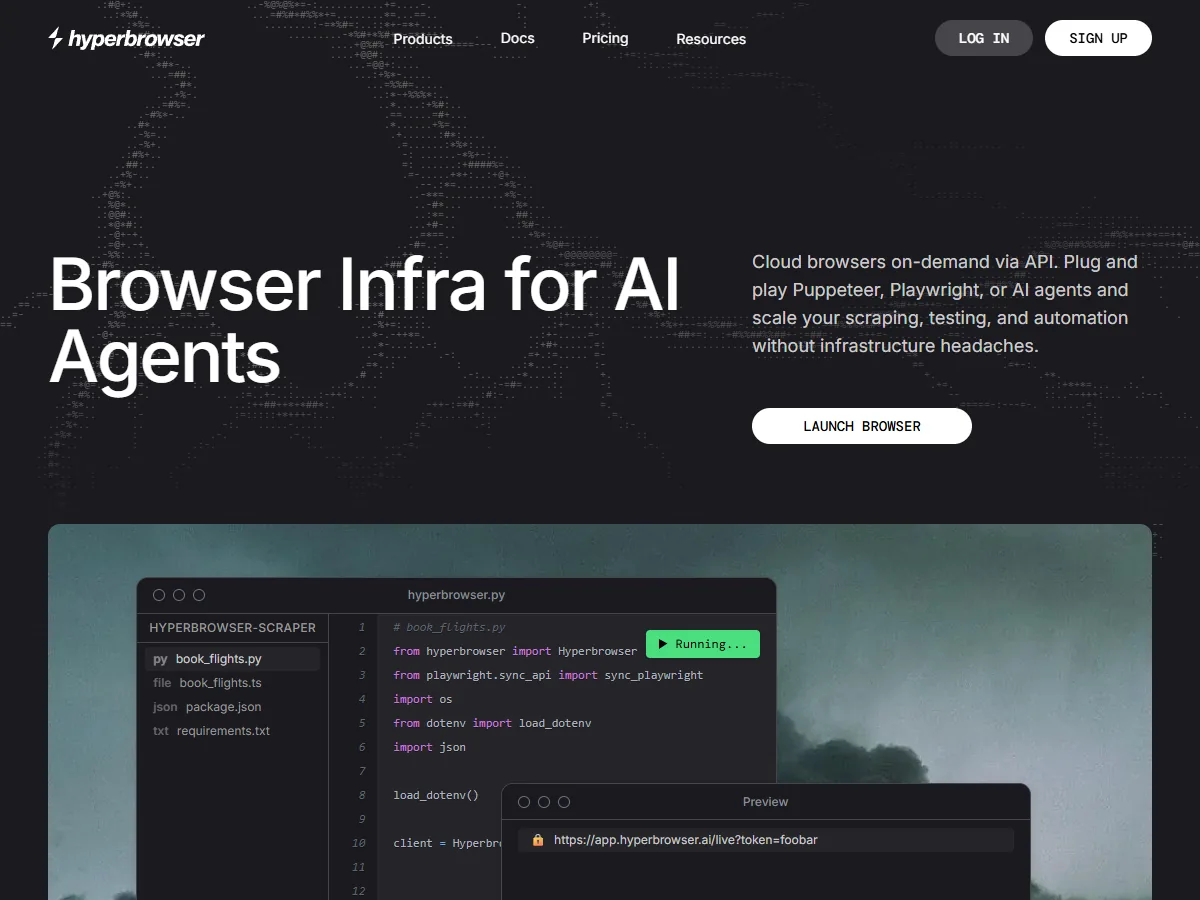
 Hyperbrowser
 同时提供单页 Scrape 与可 CDP 连接的云浏览器 Session。多数“把页面变成 markdown/HTML/链接”的任务,应先走 Scrape;只有登录后多步点击、复杂状态机或必须自己驱动 Playwright 时,再创建 Session。两条路径的完成标准不同:Scrape 看 data 里的目标格式是否齐全,Session 看脚本产物是否正确且会话已 stop。
安装官方 SDK 后,用 API Key 初始化客户端,对公开页(文档示例常用 https://example.com)调用 scrape.startAndWait。底层是异步任务:POST /api/scrape 先返回 jobId,再轮询到 completed 或 failed(还有 pending / running)。成功响应应能读到 data.metadata(如 title)以及请求的格式内容;默认常取 markdown。先确认标题与正文段落覆盖你的字段清单,再谈代理和隐身。
内容被地区限制或挑战页挡住时,再在同一次 Scrape 上附加 sessionOptions:如 useProxy、proxyCountry、useStealth / useUltraStealth、solveCaptchas。官方说明代理与验证码能力通常属于付费项,且会变慢,因此只在复现到真实阻塞后启用。也可设置 formats、waitFor、waitUntil、onlyMainContent 与标签过滤;截图里 fullPage 与 cropToContent 不能同时为 true。
| 现象 | 保留在 Scrape | 升级到 Session |
|---|---|---|
| 缺主文、噪声多 | 调整 formats / 标签 / wait | 否 |
| 地区或验证码墙 | 先加 sessionOptions | 仍失败再升 |
| 必须登录后点多步 | 不适合硬撑 Scrape | 是,改 CDP 脚本 |
| 只要结构化字段且可用提示词 | 评估 Extract 类能力 | 视交互深度 |
创建 Session 后检查 status 是否为 active,保存 id、wsEndpoint、liveUrl。Playwright 使用 connectOverCDP(session.wsEndpoint),在默认上下文执行登录与导航;可用 liveUrl 人工盯盘。默认断开自动化连接往往会结束会话;若需跨断开保活,按文档在 WebSocket URL 追加 keepAlive=true,并注意关闭全部页面仍可能导致会话结束。无论成功失败,都在 finally 调用 sessions.stop(session.id),再确认状态变为 closed。
把最终采用的 formats、sessionOptions、是否升级 Session,以及一份对照原页的 markdown/字段样例写进配置版本号。下次同类站点优先复用该版本;只有复现到新阻塞时才加代理或验证码项,避免每次任务都从零猜测参数组合。
入口:https://www.hyperbrowser.ai/ ,文档:https://docs.hyperbrowser.ai/