
Inkling 2 Mini 官方约 20 GB 的检查点支持图文输入。社区项目 LookAtMyQuant 为 Apple 芯片 Mac 提供四档 MLX 文本量化包,最小一档是 5.38 GB。作者用相同测试设置对比后,8.87 GB 档的 HumanEval 为 149/164,5.38 GB 档降至 116/164。选档先看自己是否需要图像输入,再看可用统一内存和常用任务。
官方约 20 GB 与社区文本包分别包括什么?
在官方 Hugging Face 仓库,两份主要的权重文件是约 19.53 GB 的主检查点和约 636 MB 的多 token 预测头。官方模型卡说明发布文件采用混合 NVFP4 和 MXFP8 精度。看这个体积时,要把磁盘上的检查点和加载后的内存占用分开。
LookAtMyQuant 将原始文本部分记为 18.89 GB,表中的 BF16 teacher 是作者评测用的基准称呼。四个社区包只打包文本权重。表里的视觉测试接入了独立的约 637 MB 视觉组件,公开量化包并未附带它。作者另提供约 179 MB 的 DSpark 草稿模型,可以选配来加速文本解码。
5.4GB、8.9GB、11.2GB、12.8GB 四档,质量掉在哪?
Inkling 2 Mini 本身是 26.4B 总参数、每个 token 每层路由到部分专家的循环 MoE(混合专家)模型(中间 12 层循环 3 次,形成 48 次逻辑访问)。LookAtMyQuant 没有一刀切地把所有层降到同一比特,而是先按 48 次逻辑访问和专家使用频次做动态规划,把冷门专家塞进极低比特的哈希向量网格码(trellis coding),再给高敏专家和词表尾部留更高精度。
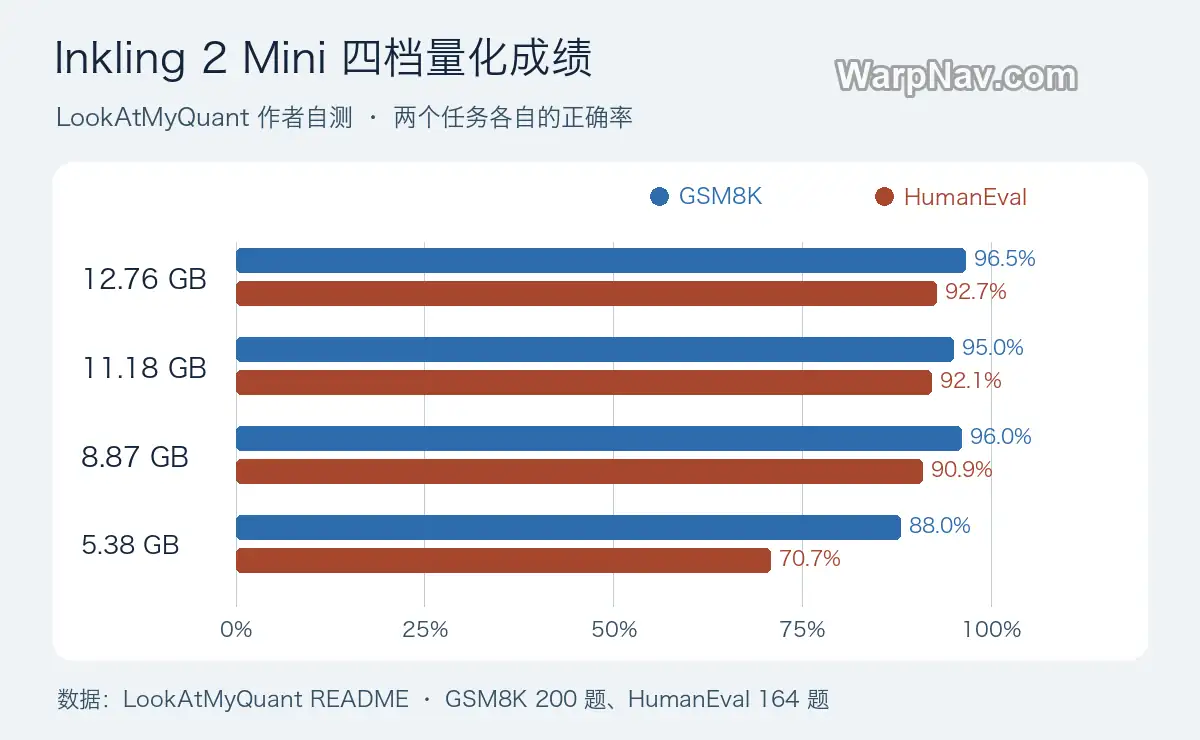
作者对高精度档保留了部分原有权重编码,对 5.4 GB 和 8.9 GB 档还做了微调。下表是同一组文本测试,最多生成 1,536 个 token,使用贪心解码并关闭长推理模式。GSM8K 取 200 题,HumanEval 取 164 题。
| 文本权重档位 | GSM8K | HumanEval |
|---|---|---|
| 作者使用的原版文本基准 18.89 GB | 193/200(96.5%) | 152/164(92.7%) |
| 12.76 GB | 193/200(96.5%) | 152/164(92.7%) |
| 11.18 GB | 190/200(95.0%) | 151/164(92.1%) |
| 8.87 GB | 192/200(96.0%) | 149/164(90.9%) |
| 5.38 GB | 176/200(88.0%) | 116/164(70.7%) |
最小档的 HumanEval 比文本基准少约 22 个百分点。作者还补充,若按更严格的答案格式验收,5.38 GB 档是 105/164。12.76 GB 在这两项得分与基准相同,8.87 GB 在这组数据中则保住了大部分分数。日常代码质量还需用实际仓库的任务判断。
Mac 怎么按可用内存和用途试档?
这批模型按作者的 Apple Silicon MLX 运行时打包。Windows 和 Linux 要另外核对支持所用引擎的权重格式。社区也有 Inkling 2 Mini 的 GGUF 包,使用前查对应引擎的模型架构支持。作者另做了 384-token 的跨格式对照,题目预算和上表不同,阅读时应看各自的测试设置。
磁盘体积只算下载的文本权重。作者在一台 M5 Max 上搭配草稿模型测得活跃 MLX 内存,5.4 GB 档约为 5.98 GB,8.9 GB 档约为 9.41 GB,11.2 GB 档约为 11.13 GB,12.8 GB 档约为 12.72 GB。系统、IDE 和上下文缓存还要额外占空间。选档时可以把这组数据当起点。
- 8 GB Mac。 5.4 GB 档可尝试很短的任务。保持浏览器和编辑器打开时,要留意活动监视器的内存压力与交换情况。
- 16 GB Mac。 做短代码问答可先试 8.9 GB 档。内存压力持续升高时,先压短上下文,或在可以接受质量损失的场景改用 5.4 GB 档。
- 24 GB 或以上。 想保留更多文本质量,可以对比 11.2 GB 与 12.8 GB 两档。需要读截图则优先查看官方图文模型的部署方案。官方模型卡列出的 Apple 芯片设备起点为 32 GB 统一内存。
在 Apple 芯片 Mac 上,量化作者给出了 lamq 安装和测试命令。新建 Python 环境后安装,再按模型卡的仓库名启动:
python3 -m venv .inkling-venv
source .inkling-venv/bin/activate
python -m pip install git+https://github.com/ShinMegamiBoson/lookatmyquant.git

lamq chat shinmegamiboson/Inkling-2-Mini-LookAtMyQuant-8.9GB \
  --drafter shinmegamiboson/Inkling-2-Mini-LookAtMyQuant-drafter
计划拿来写代码,还要再测什么?
可以用同一段实际代码,分别试修一条报错、解释一段函数和补测试。用相同的上下文和提示词,记录能否通过自己的测试、等待时间以及内存压力。作者在 M5 Max 上报给 8.9 GB 档的串行速度为 63.5 tok/s,加配草稿模型后的中位数是 106.0 tok/s。电脑、输入长度和任务变了,这组速度也会变。
上面的表说明的是作者这些题的结果。视觉测试只有外挂组件下的四题,两项文本基准也无法覆盖长上下文、复杂仓库和常用中文提示。建议先按自己的高频任务确认量化损失,再决定常用哪一档。
资料来源
- LookAtMyQuant GitHub 仓库(四档自测与 MLX 运行说明):ShinMegamiBoson/lookatmyquant
- LookAtMyQuant 方法说明与局限页面:lookatmyquant.pages.dev
- Hugging Face 社区量化权重仓库(5.4GB / 8.9GB / 11.2GB / 12.8GB):Inkling-2-Mini-LookAtMyQuant-5.4GB、8.9GB、11.2GB、12.8GB
- 官方模型说明和权重文件。Thinking Machines 发布公告 · 官方文件清单
© 版权声明
本站部分内容源于网络收集,文章等版权归原作者所有,若需删稿请联系管理员邮箱:satomini@warpnav.com
相关文章


暂无评论...
